可移植可执行文件 (PE) 格式
可移植可执行文件 (PE) 格式是 Windows 用于可执行文件的标准文件格式,例如 .exe and .dll。它是与 Windows NT (1993) 并成为双方的统一布局 32 位和 64 位 对 PE 内部结构的深入了解是在 Windows 上构建安全工具的先决条件,包括防病毒引擎、静态分析器、解包器和事件响应实用程序。
PE一览
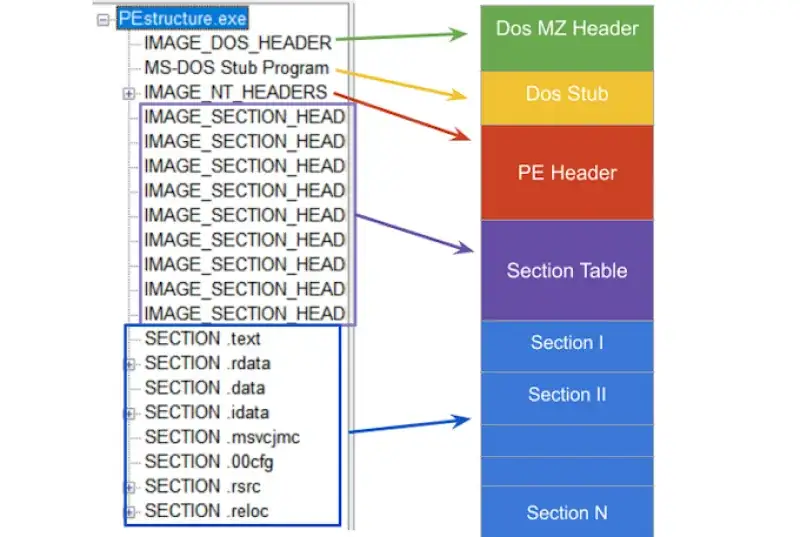
一个典型的PE文件包含:
- DOS头 (
IMAGE_DOS_HEADER)用于旧版兼容性和定位 NT 标头。 - NT 标头 (
IMAGE_NT_HEADERS32/64),其中包括:IMAGE_FILE_HEADERIMAGE_OPTIONAL_HEADER32/64(该名称是历史性的,对于 PE 图像来说实际上是强制性的)
- 截面表 (数组的
IMAGE_SECTION_HEADER) - 部分 比如
.text,.rdata,.data,.rsrc等 - 数据目录 (导入、导出、资源、重定位、调试、TLS……)大多数与 PE 相关的结构和常量都在 WinNT.h.
IMAGE_DOS_HEADER
IMAGE_DOS_HEADER 是 MS-DOS 兼容性的遗留结构。在实践中,两个最重要的领域是:
e_magic标识 DOS 标头的签名。对于 PE 文件,它必须是 0x5A4D 对应于 ASCII “MZ” (IMAGE_DOS_SIGNATURE).e_lfanew文件偏移量(从文件开头)到 NT 标头 (IMAGE_NT_HEADERS).
typedef struct _IMAGE_DOS_HEADER {
  WORD  e_magic;    // 0x5A4D ("MZ")
  WORD  e_cblp;
  WORD  e_cp;
  WORD  e_crlc;
  WORD  e_cparhdr;
  WORD  e_minalloc;
  WORD  e_maxalloc;
  WORD  e_ss;
  WORD  e_sp;
  WORD  e_csum;
  WORD  e_ip;
  WORD  e_cs;
  WORD  e_lfarlc;
  WORD  e_ovno;
  WORD  e_res[4];
  WORD  e_oemid;
  WORD  e_oeminfo;
  WORD  e_res2[10];
  DWORD e_lfanew;   // offset of IMAGE_NT_HEADERS
} IMAGE_DOS_HEADER, *PIMAGE_DOS_HEADER;
MZ and e_lfanew
“MZ”签名的历史
在 20 世纪 80 年代初期,MS-DOS 需要一种简单的方法来区分可执行文件和其他文件类型。 “神奇数字” MZ 在可执行文件开始时选择并写入。今天,此签名仍然作为 PE 兼容性的一部分。它存储在 IMAGE_DOS_HEADER.e_magic as 0x5A4D.
IMAGE_NT_HEADERS(32 和 64)
NT 标头是随 Windows NT 引入的,以标准化可执行文件加载。有两种形式:
IMAGE_NT_HEADERS32IMAGE_NT_HEADERS64两者都包含:Signature(必须是 “PE\0\0”,又名IMAGE_NT_SIGNATURE)IMAGE_FILE_HEADERIMAGE_OPTIONAL_HEADER32/64微软文档:- https://learn.microsoft.com/en-us/windows/win32/api/winnt/ns-winnt-image\_nt\_headers32
- https://learn.microsoft.com/en-us/windows/win32/api/winnt/ns-winnt-image\_nt\_headers64
typedef struct _IMAGE_NT_HEADERS32 {
  DWORD Signature;
  IMAGE_FILE_HEADER FileHeader;
  IMAGE_OPTIONAL_HEADER32 OptionalHeader;
} IMAGE_NT_HEADERS32, *PIMAGE_NT_HEADERS32;
typedef struct _IMAGE_NT_HEADERS64 {
  DWORD Signature;
  IMAGE_FILE_HEADER FileHeader;
  IMAGE_OPTIONAL_HEADER64 OptionalHeader;
} IMAGE_NT_HEADERS64, *PIMAGE_NT_HEADERS64;
NT headers layout
IMAGE_FILE_HEADER
IMAGE_FILE_HEADER 概括地描述了图像:架构、部分数量、时间戳和属性。微软文档:
typedef struct _IMAGE_FILE_HEADER {
  WORD  Machine;
  WORD  NumberOfSections;
  DWORD TimeDateStamp;
  DWORD PointerToSymbolTable;
  DWORD NumberOfSymbols;
  WORD  SizeOfOptionalHeader;
  WORD  Characteristics;
} IMAGE_FILE_HEADER, *PIMAGE_FILE_HEADER;
关键领域:
Machine目标 CPU 架构(例如IMAGE_FILE_MACHINE_I386,IMAGE_FILE_MACHINE_AMD64).NumberOfSections随后的节标题计数。TimeDateStampUNIX 纪元秒。对于调试、版本控制、分类很有用。SizeOfOptionalHeader可选标头结构的大小。Characteristics标志如:IMAGE_FILE_EXECUTABLE_IMAGEIMAGE_FILE_DLLIMAGE_FILE_32BIT_MACHINEIMAGE_FILE_DEBUG_STRIPPED
IMAGE_OPTIONAL_HEADER(32 和 64)
尽管有这个名称,但这个标头是必不可少的。它包含内存布局信息、入口点、对齐方式、子系统和 数据目录 数组。微软文档:
- https://learn.microsoft.com/en-us/windows/win32/api/winnt/ns-winnt-image\_optional\_header32
- https://learn.microsoft.com/en-us/windows/win32/api/winnt/ns-winnt-image\_optional\_header64Highlights:
Magic0x10B对于 PE32 或0x20B适用于 PE32+(64 位)。AddressOfEntryPoint入口点的 RVA。ImageBase首选加载地址。SectionAlignmentandFileAlignment内存中与磁盘上的对齐。SizeOfImageandSizeOfHeaders内存中图像大小和总标题大小。DataDirectory[]指向导入表、导出表、重定位、资源等的指针。
IMAGE_SECTION_HEADER
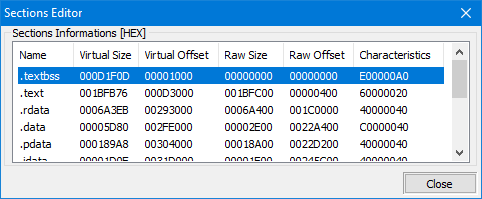
一个PE被分成 sections,每个描述为 IMAGE_SECTION_HEADER。节是加载器和工具使用的基本映射单元。微软文档:
#pragma pack(push, 1)
typedef struct _IMAGE_SECTION_HEADER {
  BYTE  Name[IMAGE_SIZEOF_SHORT_NAME];  // 8
  union {
    DWORD PhysicalAddress;
    DWORD VirtualSize;
  } Misc;
  DWORD VirtualAddress;
  DWORD SizeOfRawData;
  DWORD PointerToRawData;
  DWORD PointerToRelocations;
  DWORD PointerToLinenumbers;
  WORD  NumberOfRelocations;
  WORD  NumberOfLinenumbers;
  DWORD Characteristics;
} IMAGE_SECTION_HEADER, *PIMAGE_SECTION_HEADER;
#pragma pack(pop)
典型的部分名称:
.text可执行代码.rdata只读数据.data初始化可写数据.bss未初始化的数据(通常只是虚拟的).rsrc资源 文章中的图片: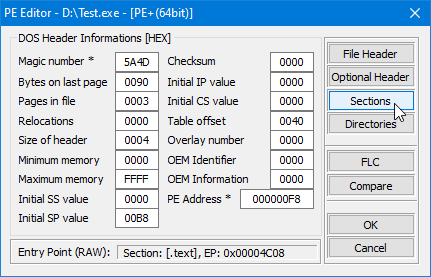
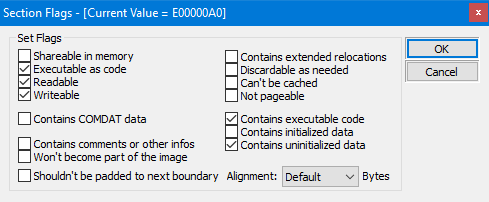
虚拟地址与物理地址(文件偏移量)
在PE中,许多字段表示为 RVA (相对虚拟地址)。 RVA 是相对于内存中模块基址的地址。在磁盘上,数据位于 文件偏移量如果您需要使用 RVA 访问磁盘上的某些内容,则必须使用 RVA 到文件偏移量转换(通常称为 rva2offset).RVA vs file offset
进口
当可执行文件依赖于外部函数时(例如来自 user32.dll 或第三方 DLL),它在 导入目录Windows 加载器在加载时解析导入并填充 导入地址表 (IAT) 与实际的函数指针。编译器通常通过 IAT 生成间接调用。Import table concept
IMAGE_IMPORT_DIRECTORY(导入目录表)
导入目录是一个序列 IMAGE_IMPORT_DESCRIPTOR 结构。每个描述符描述一个导入的 DLL。
typedef struct _IMAGE_IMPORT_DESCRIPTOR {
  union {
    DWORD Characteristics;        // 0 for terminating null import descriptor
    DWORD OriginalFirstThunk;     // RVA to unbound IAT (lookup table)
  } DUMMYUNIONNAME;
  DWORD TimeDateStamp;
  DWORD ForwarderChain;
  DWORD Name;                    // RVA to DLL name
  DWORD FirstThunk;              // RVA to IAT (addresses after binding)
} IMAGE_IMPORT_DESCRIPTOR;
文章中的可视化:
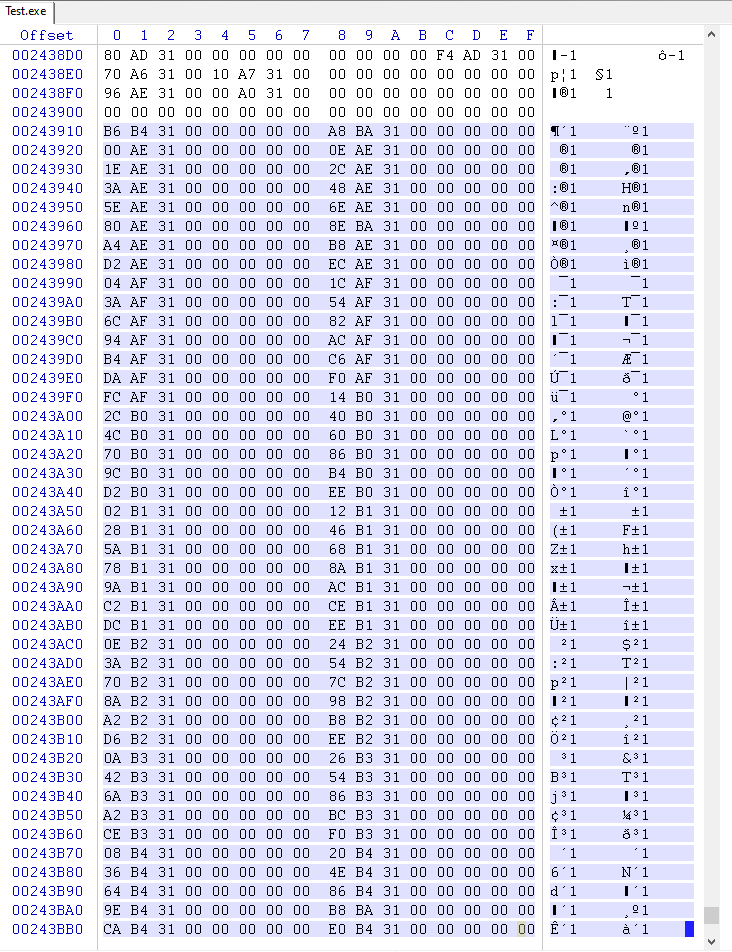
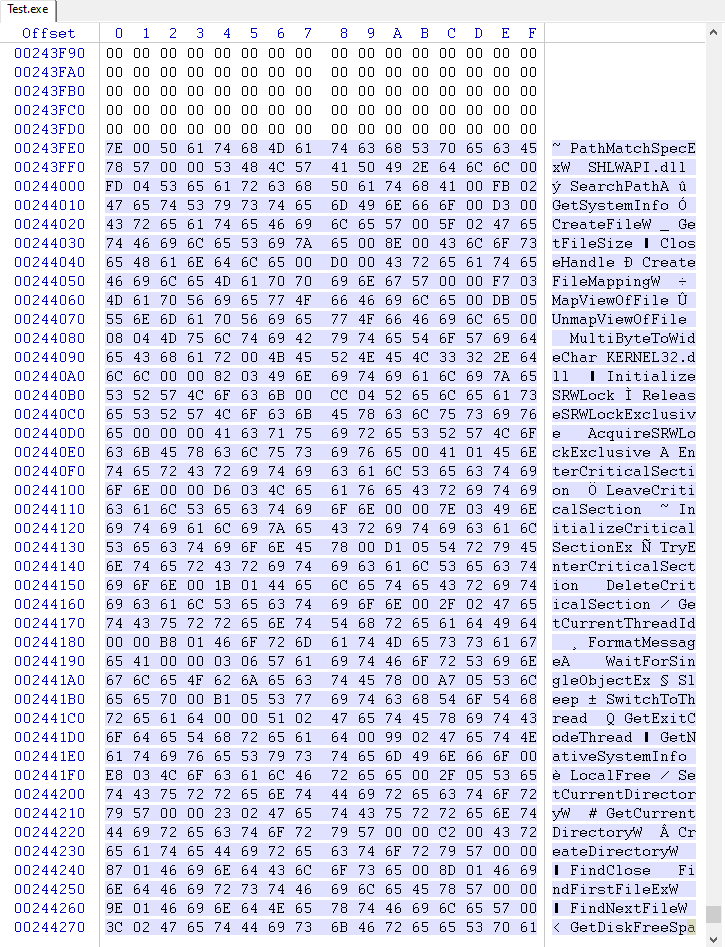
导入调用的工作原理
典型的编译器输出通过加载器填充一次的单元进行调用:
; x86
call dword ptr [_cell_with_address_of_function]
; x64
call qword ptr [_cell_with_address_of_function]
IAT call加载器只需将函数地址写入IAT一次,代码就通过它不断调用。
C++ 导入表解析器 (x86 + x64)
下面是一个紧凑实用的方法:
- 验证 DOS 标头和 PE 签名
- 检测架构
IMAGE_FILE_HEADER.Machine - 找到部分和数据目录
- 将 RVA 转换为文件偏移量 (
rva2offset) - 步行
IMAGE_IMPORT_DESCRIPTORentries - 对于每个导入的函数,检测按名称导入与按序号导入
alignUp
DWORD alignUp(DWORD value, DWORD align) {
  DWORD mod = value % align;
  return value + (mod ? (align - mod) : 0);
}
rva2offset
static constexpr int64_t kRvaError = -1;
int64_t rva2offset(const IMAGE_NTPE_DATA& ntpe, DWORD rva) {
  try {
    PIMAGE_SECTION_HEADER sec = ntpe.sectionDirectories;
    // If rva is inside headers, return as-is
    if (!ntpe.fileHeader->NumberOfSections || rva < sec->VirtualAddress) {
      return rva;
    }
    for (uint32_t i = 0; i < ntpe.fileHeader->NumberOfSections; i++, sec++) {
      DWORD secEnd = alignUp(sec->Misc.VirtualSize, ntpe.SecAlign) + sec->VirtualAddress;
      if (sec->VirtualAddress <= rva && secEnd > rva) {
        return (int64_t)rva - sec->VirtualAddress + sec->PointerToRawData;
      }
    }
  } catch (...) {
  }
  return kRvaError;
}
导入行走核心理念
// Pseudocode outline
// 1) Find DataDirectory[IMPORT].VirtualAddress
// 2) Convert RVA -> file offset
// 3) Walk IMAGE_IMPORT_DESCRIPTOR until Name == 0
// 4) For each descriptor, walk thunk table until entry == 0
// 5) If high-bit set -> ordinal, else -> name (IMAGE_IMPORT_BY_NAME)
本文项目以即用型形式实现了这一点,包括 x86 和 x64 支持。
使用的工具
- 体育工具: https://github.com/petoolse/petoolsOpen-source 用于操作 PE 标头字段的工具。支持 x86 和 x64。
- 数据库管理工具: https://learn.microsoft.com/en-us/windows-hardware/drivers/debugger/debugger-download-toolsMicrosoft 系统调试器。
- x64dbg: https://x64dbg.com/Lightweight Windows 的开源调试器。
- WinHex: http://www.winhex.com/winhex/hex-editor.htmlUniversal 用于取证、恢复和低级数据编辑的十六进制编辑器。
接下来是什么
原文章中建议的后续步骤:
- 构建模糊哈希模块
- 讨论黑名单和白名单
- 围绕 PE 解析和分析扩展工具 文章中的联系人:articles@stofu.io