Hash
Först och främst, låt oss gå igenom grunderna och bekanta oss med ett sådant koncept som en hash!
Hash-algoritm är en matematisk funktion som tar in data av alla storlekar och producerar en utdata som kallas a hash or meddelandesammanfattning. Utdata är en unik representation av indata, som kan användas för att verifiera att data inte har manipulerats. Hashalgoritmer används för att säkerställa datas integritet och äkthet.
Enkelt uttryckt är en hash ett unikt digitalt fingeravtryck av en databit. Det är som en kod som representerar data. Koden genereras av en matematisk funktion som kallas a hash-funktion. Om data ändras ens lite, kommer hashen att vara annorlunda.
Det finns primära nyckelegenskaper för hash:
- Deterministisk: En hashfunktion ska alltid producera samma utdata för en given ingång. Det betyder att om du hash samma data två gånger, bör du få samma hashvärde båda gångerna.
- Oåterkallelighet: Det borde vara beräkningsmässigt omöjligt att rekonstruera den ursprungliga indata från dess hashvärde. Den här egenskapen är viktig för säkerheten, eftersom den skyddar originaldata från att upptäckas av angripare som bara har tillgång till hashvärdet.
- Enhetlighet: En hashfunktion bör producera en enhetlig fördelning av hashvärden över alla möjliga indata. Detta innebär att varje hashvärde bör vara lika sannolikt att inträffa, och det bör inte finnas några mönster eller fördomar i fördelningen av hashvärden.
- Oförutsägbarhet: Det borde vara beräkningsmässigt omöjligt att förutsäga hashvärdet för en indata baserat på hashvärdena för andra indata eller egenskaperna för själva hashfunktionen. Denna egenskap är viktig för säkerheten, eftersom den gör det svårt för angripare att skapa en kollision (två olika ingångar som producerar samma hashvärde).
- Motstånd mot kollisionsattacker: En hashfunktion ska vara resistent mot kollisionsattacker, vilket innebär att man hittar två olika ingångar som producerar samma hashvärde. Kollisionsattacker kan användas för att skapa falska digitala signaturer eller för att kringgå åtkomstkontroller, så det är viktigt att en hashfunktion är designad för att motstå dem.
Andra egenskaper hos hash kan du hitta på Wikipedia-sidan:https://en.wikipedia.org/wiki/Hash\_function
Dataverifiering. Svartlista och vitlista.
I samband med antivirusprogram används hashalgoritmer för att upptäcka skadlig programvara eller utesluta falska positiva varningar. Antivirusprogram upprätthåller en databas med kända hashprogram för skadlig programvara (blacklist) och betrodda mjukvaruhashar (whitelist). När en fil skannas jämförs dess hash med hasharna i databasen.
De vanligaste hashalgoritmerna för dataverifiering är MD5, SHA-1, SHA-256 and SHA-512.
Användningen av hash i antivirussvarta listor och vitlistor hjälper till att påskynda skanningsprocessen, eftersom antivirusprogrammet inte behöver utföra en detaljerad analys av varje fil för att avgöra om den är skadlig eller inte. Istället kan den jämföra hash-värdena för filer med dem i svartlistan/vitlistan för att snabbt identifiera kända hot eller betrodda appar.
Svartlista
I samband med cybersäkerhet och antivirusprogram är en svartlista en lista över kända skadliga filer eller delar av dessa filer. När ett antivirusprogram skannar en dator eller ett nätverk jämför det filerna och enheterna som det stöter på mot den svarta listan för att identifiera eventuella hot. Om en fil eller enhet matchar en post på den svarta listan kommer antivirusprogrammet att vidta åtgärder för att ta bort eller placera den i karantän för att förhindra att den orsakar skada.
Även om svarta listor kan vara användbara för att upptäcka och förhindra kända hot, är de inte alltid effektiva för att skydda mot nya och okända hot. Angripare kan använda olika tekniker, såsom obfuskering eller polymorfism, för att modifiera koden eller beteendet hos en fil eller enhet för att undvika upptäckt av antivirusprogram.
Därför använder antivirusprogram ofta en kombination av tekniker, som t.ex whitelisting och beteendebaserad upptäckt, för att komplettera användningen av svarta listor och ge ett mer omfattande skydd mot ett bredare spektrum av hot.
Vitlista
I samband med cybersäkerhet och antivirusprogram är en vitlista en lista över betrodda filer som är kända för att vara säkra. Om en fil eller enhet matchar en post på vitlistan kommer antivirusprogrammet att tillåta den att öppna/köras utan att vidta några åtgärder, eftersom den anses vara säker.
Vitlistor är användbara för att förhindra falska positiva resultat i antivirus- och säkerhetsprogram. Falska positiva resultat uppstår när ett program eller en fil flaggas som skadlig eller skadlig när den faktiskt är säker. Genom att använda en vitlista kan säkerhetsprogram kringgå dessa falska positiva, vilket kan spara tid och förhindra onödiga varningar.
Att använda hash- och svartlistor/vitlistor kan vara ett effektivt sätt att skydda sig mot kända hot och förhindra falska positiva resultat i antivirus- och säkerhetsprogram.
Varför använder antivirus flera hashalgoritmer?
Antivirusprogram använder flera hashalgoritmer av flera anledningar:
- Motstånd mot kollisionerÄven om svartlistor kan vara effektiva för att upptäcka och förhindra kända hot, är de inte idiotsäkra. Angripare kan använda olika tekniker för att undvika upptäckt, som att modifiera data för att undvika att matcha signaturerna i den svarta listan. Dessa tekniker kallas "kollisionsattacker". <br> En kollisionsattack är en typ av kryptografisk attack där en angripare försöker hitta två olika indata, såsom filer eller meddelanden, som producerar samma hashvärde när de körs genom en hashfunktion (kollision). Målet med en kollisionsattack är att skapa ett par ingångar som kan användas för att undergräva ett system som förlitar sig på integriteten hos hashvärden, såsom digitala signaturer, lösenordsautentisering eller dataintegritetskontroller. Om en angripare kan hitta en kollision kan han använda den för att kringgå säkerhetsåtgärderna som är beroende av hashfunktionen. <br> För att minska risken för kollisionsattacker använder antivirus starka hashfunktioner som är resistenta mot attacker och använder flera hashfunktioner samtidigt. Till exempel, om ett antivirusprogram bara använde MD5-hashalgoritm, kan en angripare potentiellt skapa en skadlig fil som har samma MD5-hash som en legitim fil, och lura antivirusprogrammet att behandla den skadliga filen som säker. Men att använda flera hashalgoritmer, som MD5, SHA-1 och SHA-256, gör det svårare för en angripare att skapa en kollisionsattack som skulle fungera mot alla algoritmer samtidigt.
- EffektivitetOlika hashalgoritmer har olika beräkningskrav, och vissa kan vara mer effektiva än andra beroende på filstorlek, typ eller andra faktorer. Genom att använda flera hashalgoritmer kan antivirusprogram välja den mest lämpliga algoritmen för en given situation, vilket kan spara tid och processorkraft. Till exempel kan SHA-256 vara mer beräkningsintensiv än MD5, så ett antivirusprogram kan välja att använda MD5 för mindre filer och SHA-256 för större filer.
- FlexibilitetOlika hashalgoritmer är designade för olika användningsfall och applikationer. Genom att använda flera hashalgoritmer kan antivirusprogram anpassa sig till olika behov och scenarier, som att upptäcka skadlig programvara, verifiera filintegritet eller upptäcka manipulering eller modifiering. Till exempel kan en rättsmedicinsk utredare använda en annan hashalgoritm än ett antivirusprogram för att säkerställa att data inte har ändrats under en utredning.
Att använda flera hashalgoritmer är en bästa praxis vid utveckling av cybersäkerhet och antivirusprogram, eftersom det ger robusthet, kompatibilitet, effektivitet och flexibilitet för att upptäcka och förebygga cyberhot.
Hur känner antivirus igen liknande men inte identiska data och filer?
Liknande men inte identiska filer kan vara ett problem inom cybersäkerhet eftersom de kan användas av angripare för att undvika upptäckt av antivirusprogram.
En angripare kan till exempel ta en fil med känd skadlig programvara och göra små ändringar i dess kod eller struktur, som att ändra variabelnamn eller ändra ordningsanvisningar. Dessa ändringar kan räcka för att skapa en ny fil som liknar men inte är identisk med den ursprungliga skadliga filen, och som kanske inte upptäcks av antivirusprogram som bygger på traditionella hash-baserade upptäcktsmetoder.
Dessutom kan angripare använda liknande men inte identiska filer för att skapa polymorf skadlig kod, som kan ändra dess kod eller struktur med varje infektion för att undvika upptäckt. Polymorf skadlig kod kan vara mycket svår att upptäcka med traditionella antivirustekniker, som är beroende av att känna igen specifika mönster eller signaturer i skadlig kod.
För att lösa detta problem använder antivirus luddig hash.
Fuzzy hashing är en teknik som används av vissa antivirusprogram för att upptäcka liknande men inte identiska filer, inklusive polymorf skadlig kod. Genom att dela upp en fil i mindre bitar och jämföra hash av dessa bitar med de för andra filer, kan fuzzy hashing identifiera filer som har liknande kod eller struktur, även om de inte är identiska.
Fuzzy hashing fungerar genom att identifiera sekvenser av byte som förekommer ofta i filen. Dessa sekvenser, även kända som "chunks", hashas sedan med en kryptografisk hashfunktion för att generera ett hashvärde. Hashvärdena för bitarna jämförs sedan med de för andra filer för att identifiera bitar som liknar varandra.
Fördelen med fuzzy hashing är att den kan upptäcka likheter även när filer har modifierats eller fördunklats, vilket gör det till ett kraftfullt verktyg för att identifiera varianter av känd skadlig programvara. Till exempel, om en angripare modifierar en känd skadlig fil genom att ändra namnen på variabler eller funktioner, kanske traditionella hashbaserade upptäcktsmetoder inte upptäcker den modifierade filen. Fuzzy hashing kan dock fortfarande upptäcka den modifierade filen genom att identifiera bitar som liknar dem i den ursprungliga skadliga filen.
Till skillnad från kryptografiska hashalgoritmer som MD5, SHA-1 eller SHA-512 producerar fuzzy hashing-algoritmer hashvärden med variabel längd som är baserade på likheten mellan indata.
Fördelar med fuzzy hashes
- Detektering av liknande filer: Fuzzy hash kan upptäcka liknande filer även om de har modifierats något, vilket är användbart för att identifiera varianter av känd skadlig programvara.
- Minskade falska positiva: Fuzzy hash kan minska antalet falska positiva resultat som genereras av traditionella hash-baserade detektionsmetoder. Detta beror på att fuzzy hashes kan upptäcka filer som liknar men inte identiska med känd skadlig programvara.
- Motståndskraft mot förvirring: Fuzzy hashes är mer motståndskraftiga mot obfuskeringstekniker som används av angripare för att undvika upptäckt. Detta beror på att den luddiga hashalgoritmen delar upp filen i mindre bitar och genererar hash för varje bit, vilket gör det svårare för en angripare att modifiera filen på ett sätt som undviker upptäckt.
Begränsningar för fuzzy hashing
- Falskt positivt: Fuzzy hashing kan ge falska positiva resultat, där legitima filer flaggas som skadliga eftersom de har liknande kod eller struktur som känd skadlig kod. Detta kan inträffa om filerna delar gemensamma bibliotek eller ramverk.
- Prestanda: Fuzzy hashing kan vara beräkningskrävande, särskilt för stora filer. Detta kan sakta ner skanningsprocessen och påverka systemets prestanda.
- Storleksbegränsningar: Fuzzy hashing kanske inte fungerar bra på mycket små filer eller filer med låg entropi, eftersom det kanske inte finns tillräckligt med unika bitar för att generera meningsfulla hash.
- manipulering: Fuzzy hashing kanske inte är effektiv om en angripare specifikt riktar sig mot den och modifierar en fil för att undvika upptäckt. Till exempel kan en angripare medvetet ändra strukturen på en fil för att förhindra att den identifieras av fuzzy hashing.
Vad är skillnaden mellan kryptografiska hashalgoritmer och fuzzy hashalgoritmer?
Kryptografiska hashalgoritmer och fuzzy hashalgoritmer används båda inom cybersäkerhet, men de har olika syften och egenskaper.
Kryptografiska hashalgoritmer, som SHA-256 och MD5, är designade för att ge dataintegritet och autenticitet genom att generera unika hashvärden med fast längd som är nästan omöjliga att omvända. Kryptografiska hashalgoritmer används för att verifiera dataintegriteten.
Fuzzy hash-algoritmer, som SSDEEP, är utformade för att identifiera liknande men inte identiska data, till exempel filer som har modifierats eller ompaketerats av skadlig programvara. Fuzzy hashing använder en glidande fönsterteknik för att dela upp data i små bitar och generera probabilistiska hash med variabel längd som jämförs med en databas med kända hash för skadlig programvara för att identifiera potentiellt skadliga filer.
Kryptografiska hash-algoritmer är designade för att vara kollisionsbeständiga, vilket innebär att det är extremt svårt att hitta två ingångar som producerar samma hash-utdata. Fuzzy hash-algoritmer behöver inte vara kollisionsbeständiga eftersom de är designade för att upptäcka likheter mellan filer snarare än att producera unika hash-utdata.
Den största skillnaden mellan kryptografiska hashalgoritmer och fuzzy hashalgoritmer är deras nivå av determinism. Kryptografiska hash-algoritmer producerar fast längd, deterministiska hash som är unika för varje ingång, medan fuzzy hash-algoritmer producerar variabel längd, probabilistiska hash som är liknande för liknande indata.
Vilka fuzzy hashing-algoritmer kommer vi att använda i vår lösning?
I vår lösning kommer vi att använda SSDEEP och TLSH.
ssdeep är en fuzzy hashing-algoritm som används för att identifiera liknande men inte identiska data, till exempel varianter av skadlig kod. Det fungerar genom att generera ett hashvärde som representerar likheten mellan indata, snarare än en unik identifierare som kryptografiska hashfunktioner. Utdata från ssdeep är variabel längd och probabilistisk, vilket gör att den kan upptäcka även mindre skillnader mellan två filer. ssdeep används ofta för analys och upptäckt av skadlig programvara, och det är också integrerat i olika säkerhetsverktyg och antivirusprogram.
TLSH (Trend Micro Locality Sensitive Hash) är en suddig hashalgoritm som används för att identifiera liknande men inte identiska data, till exempel varianter av skadlig kod. Det fungerar genom att skapa ett hashvärde som fångar de unika egenskaperna hos indata, såsom bytefrekvens och ordning. Utdata från TLSH är variabel längd och probabilistisk, vilket gör att den kan upptäcka likheter även om indata har modifierats eller fördunklats. TLSH används ofta i analys och upptäckt av skadlig programvara, och den är också integrerad i olika säkerhetsverktyg och antivirusprogram.
ssdeep och TLSH använder båda avståndsmått för att bestämma likheten mellan två hash-värden. Avståndsmåtten som används av ssdeep och TLSH är dock olika.
ssdeep använder måttet "fuzzy hash distance" för att beräkna avståndet mellan två hashvärden. Detta avståndsmått är baserat på antalet matchande och icke-matchande block mellan de två hasharna, såväl som storleken på hasharna. Avståndsmåttet är ett procentvärde som sträcker sig från 0 till 100, där 0 betyder att de två hasharna är identiska och 100 betyder att de två hasharna är helt olika.
TLSH, å andra sidan, använder måttet "total diff" för att beräkna avståndet mellan två hash-värden. Detta avståndsmått är baserat på skillnaden mellan de lokalitetskänsliga egenskaperna hos de två indatauppsättningarna. Utdata från måttet "total diff" är ett värde mellan 0 och 1000, där 0 betyder att de två hashvärdena är identiska och 1000 betyder att de två hashvärdena är helt olika.
Bygger hashmodulen
För vår lösning kommer vi att använda bibliotek med öppen källkod:
- PolarSSL: https://polarssl.org/PolarSSL är ett gratis och öppen källkodsbibliotek för att implementera kryptografiska protokoll som Transport Layer Security (TLS), Secure Sockets Layer (SSL), Datagram Transport Layer Security (DTLS). Den tillhandahåller olika kryptografiska algoritmer och protokoll, inklusive hashfunktioner, symmetrisk och asymmetrisk kryptering, digitala signaturer och nyckelutbytesalgoritmer. PolarSSL är designat för att vara lätt och effektivt, vilket gör det lämpligt för användning i miljöer med begränsade resurser.
- ssdeep: http://ssdeep.sf.net/
- TLSH: https://github.com/trendmicro/tlsh/
Efter att ha implementerat biblioteken i projektet lägger vi till en enkel kod:
struct HashData
{
 BYTE md5[16];
 BYTE sha1[20];
 BYTE sha512[64];
 std::string ssdeep;
 std::string tlsh;
};

HashData hash(const void* buff, uint64_t size)
{
 HashData snap = {};

 hashes::md5(buff, size, snap.md5);
 hashes::sha1(buff, size, snap.sha1);
 hashes::sha4(buff, size, snap.sha512);

 snap.ssdeep = hashes::ssdeepHash(buff, size);
 snap.tlsh = hashes::tlshHash(buff, size);

 return snap;
}
Kontrollerar hashmodulen
Det är dags att testa hashmodulen! För att göra detta skapar vi en textfil med följande innehåll:
All the World`s a Stage by William Shakespeare
All the world`s a stage,
And all the men and women merely players;
They have their exits and their entrances,
And one man in his time plays many parts,
His acts being seven ages. At first, the infant,
Mewling and puking in the nurse`s arms.
Then the whining schoolboy, with his satchel
And shining morning face, creeping like snail
Unwillingly to school. And then the lover,
Sighing like furnace, with a woeful ballad
Made to his mistress` eyebrow. Then a soldier,
Full of strange oaths and bearded like the pard,
Jealous in honor, sudden and quick in quarrel,
Seeking the bubble reputation
Even in the cannon`s mouth. And then the justice,
In fair round belly with good capon lined,
With eyes severe and beard of formal cut,
Full of wise saws and modern instances;
And so he plays his part. The sixth age shifts
Into the lean and slippered pantaloon,
With spectacles on nose and pouch on side;
His youthful hose, well saved, a world too wide
For his shrunk shank, and his big manly voice,
Turning again toward childish treble, pipes
And whistles in his sound. Last scene of all,
That ends this strange eventful history,
Is second childishness and mere oblivion,
Sans teeth, sans eyes, sans taste, sans everything.
TEST 1: skapa två identiska filer med samma innehåll (text ovan) och beräkna hash.


SSDEEP säger att filerna är 100% identiska. TLSH säger att det finns 0% skillnader mellan filer.
TEST 2: Skapa två identiska filer med samma innehåll, gör ändringar i den andra filen och beräkna hash
Andra filens innehåll:
All the World`s a Stage by William Shakespeare
O lovely maidens, fall in love,
But not with Muscovites,
For Muscovites are foreign folk,
They do not treat you right.
A Muscovite will love for sport,
And laughing go away;
They have their exits and their entrances,
And one man in his time plays many parts,
His acts being seven ages. At first, the infant,
Mewling and puking in the nurse`s arms.
Then the whining schoolboy, with his satchel
And shining morning face, creeping like snail
Unwillingly to school. And then the lover,
Sighing like furnace, with a woeful ballad
Made to his mistress` eyebrow. Then a soldier,
Full of strange oaths and bearded like the pard,
Jealous in honor, sudden and quick in quarrel,
Seeking the bubble reputation
Even in the cannon`s mouth. And then the justice,
In fair round belly with good capon lined,
With eyes severe and beard of formal cut,
Full of wise saws and modern instances;
And so he plays his part. The sixth age shifts
Into the lean and slippered pantaloon,
With spectacles on nose and pouch on side;
His youthful hose, well saved, a world too wide
For his shrunk shank, and his big manly voice,
Turning again toward childish treble, pipes
And whistles in his sound. Last scene of all,
That ends this strange eventful history,
Is second childishness and mere oblivion,
Sans teeth, sans eyes, sans taste, sans everything.

SSDEEP säger att filerna är 88% identiska. TLSH säger att det finns 4,7 % skillnader mellan filerna.
TEST 3: beräkna hash för två helt olika textfiler
Andra filens innehåll:
"Katerina", poem of Taras Shevchenko
(translated by John Weir)

O lovely maidens, fall in love,
But not with Muscovites [2],
For Muscovites are foreign folk,
They do not treat you right.
A Muscovite will love for sport,
And laughing go away;
He`ll go back to his Moscow land
And leave the maid a prey
To grief and shame...
It could be borne
If she were all alone,
But scorn is also heaped upon
Her mother frail and old.
The heart e`en languishing can sing –
For it knows how to wait;
But this the people do not see:
“A strumpet!“ they will say.
O lovely maidens, fall in love,
But not with Muscovites,
For Muscovites are foreign folk,
They leave you in a plight.
Young Katerina did not heed
Her parent`s warning words,
She fell in love with all her heart,
Forgetting all the world.

The orchard was their trysting-place;
She went there in the night
To meet her handsome Muscovite,
And thus she ruined her life.
Her anxious mother called and called
Her daughter home in vain;
There where her lover she caressed,
The whole night she remained.
Thus many nights she kissed her love
With passion strong and true,
The village gossips meanwhile hissed:
“A girl of ill repute!”
Let people talk, let gossips prate,
She does not even hear:
She is in love, that`s all she cares,
Nor feels disaster near.
Bad tidings came of strife with Turks,
The bugles blew one morn:
Her Muscovite went off to war,
And she remained at home.
A kerchief o`er her braids they placed
To show she`s not a maid,
But Katerina does not mind,
Her lover she awaits.
He promised her that he’d return
If he was left alive,
That he`d come back after the war –
And then she`d be his wife,
An army bride, a Muscovite
Herself, her ills forgot,
And if in meantime people prate,
Well, let the people talk!
She does not worry, not a bit –
The reason that she weeps
Is that the girls at sundown sing
Without her on the streets.
No, Katerina does not fret –
And jet her eyelids swell,
And she at midnight goes to fetch

The water from the well
So that she won`t by foes be seen;
When to the well she comes,
She stands beneath the snowball-tree
And sings such mournful songs,
Such songs of misery and grief,
The rose .itself must weep.
Then she comes home - content that she
By neighbours was not seen.
No, Katerina does not fret.
She`s carefree as can be -
With her new kerchief on her head
She looks out on the street.
So at the window day by day
Six months she sat in vain....
With sickness then was overcome,
Her body racked with pain.
Her illness very grievous proved.
She barely breathed for days ...
When it was over - by the stove
She rocked her tiny babe.
The gossips` tongues now got free rein.
The other mothers jibed
That soldiers marching home again
At her house spent the night.
“Oh, you have reared a daughter fair.
And not alone beside
The stove she sits - she`s drilling there
A little Muscovite.
She found herself a brown-eyed son...
You must have taught her how!...
Oh fie on ye, ye prattle tongues,
I hope yourselves you`ll feel
Someday such pains as she who bore
A son that you should jeer!
Oh, Katerina, my poor dear!
How cruel a fate is thine!

SSDEEP säger att filerna är helt annorlunda, med 0% matchningar. TLSH säger dock att filerna bara är 27,1 % olika.
Varför är det så? Vi överväger trots allt avståndet mellan två helt olika textfiler, eller hur?
Saken är att, som vi sa ovan, tar TLSH-algoritmen hänsyn till frekvenser. Trots att texterna är olika är de ändå skrivna på samma språk, använder samma alfabet och har ett antal av samma ord. Denna funktion i denna hashalgoritm hjälper till att upptäcka ändringar av skadliga filer.
TEST 4: jämför 2 Windows systemfiler

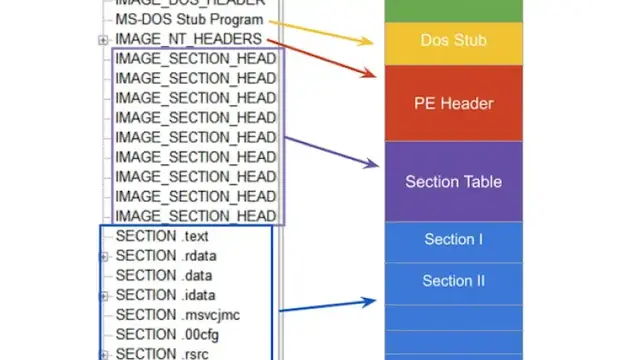
SSDEEP säger att filerna är helt annorlunda, med 0% matchningar. TLSH-algoritmen säger dock att filerna bara skiljer sig med 14,5 %. Detta beror delvis på det faktum att filerna med största sannolikhet byggdes av samma kompilator, av samma företag, möjligen med samma kodmönster. Filerna har liknande VERSION_INFO- och MZ-rubriker.
TEST 5: jämför systemfilen 2 och vår hashpair.exe-fil

SSDEEP säger att filerna är helt annorlunda, med 0% matchningar. TLSH-algoritmen säger att filerna skiljer sig markant, med 73,3%. Dessa filer kompilerades av olika företag, med hjälp av olika bibliotek och olika kompilatorer. Dessa filer har olika VERSION_INFO och olika MZ-rubriker. Således låter TLSH-algoritmen dig kategorisera körbara filer, vilket hjälper till att identifiera liknande skadliga filer eller skadliga filer från samma familj.
Lista över använda verktyg
- WinMerge: https://winmerge.orgWinMerge är ett verktyg för att skilja och sammanfoga med öppen källkod för Windows. WinMerge kan jämföra både mappar och filer och presenterar skillnader i ett visuellt textformat som är lätt att förstå och hantera.
- Anteckningar++: https://notepad-plus-plus.org/downloadsNotepad++ är en gratis (som i "fritt tal" och även som i "gratis öl") källkodsredigerare och anteckningsblocksersättning som stöder flera språk. Körs i MS Windows miljön, dess användning styrs av GNU General Public License.
GITHUB
Du kan hitta koden för hela projektet på vår github:https://github.com/SToFU-Systems/DSAVE
VAD ÄR NÄSTA?
Vi uppskattar ditt stöd och ser fram emot ditt fortsatta engagemang i vårt samhälle.
I nästa artikel kommer vi att skriva den enklaste PE-resurstolken tillsammans med dig.
Eventuella frågor från författarna till artikeln kan skickas till e-post: articles@stofu.io
Tack för din uppmärksamhet och ha en trevlig dag!