Hash
Prima di tutto, esaminiamo le nozioni di base e conosciamo un concetto come l'hashish!
Algoritmo hash è una funzione matematica che accetta dati di qualsiasi dimensione e produce un output chiamato a hash or sintesi del messaggio. L'output è una rappresentazione univoca dei dati di input, che può essere utilizzata per verificare che i dati non siano stati manomessi. Gli algoritmi hash vengono utilizzati per garantire l'integrità e l'autenticità dei dati.
In termini semplici, un hash è un'impronta digitale unica di un dato. È come un codice che rappresenta i dati. Il codice è generato da una funzione matematica chiamata a funzione hash. Se i dati cambiano anche leggermente, l’hash sarà diverso.
Esistono caratteristiche chiave primarie per l'hash:
- deterministico: Una funzione hash dovrebbe sempre produrre lo stesso output per un dato input. Ciò significa che se esegui l'hashing degli stessi dati due volte, dovresti ottenere lo stesso valore hash entrambe le volte.
- Irreversibilità: Dovrebbe essere computazionalmente impossibile ricostruire i dati di input originali dal relativo valore hash. Questa proprietà è importante per la sicurezza, poiché protegge i dati originali dalla scoperta da parte di aggressori che hanno accesso solo al valore hash.
- Uniformità: Una funzione hash dovrebbe produrre una distribuzione uniforme dei valori hash su tutti i possibili input. Ciò significa che ciascun valore hash dovrebbe avere la stessa probabilità di verificarsi e non dovrebbero esserci schemi o distorsioni nella distribuzione dei valori hash.
- Imprevedibilità: Dovrebbe essere computazionalmente impossibile prevedere il valore hash di un input in base IA valori hash di altri input o alle proprietà della funzione hash stessa. Questa proprietà è importante per la sicurezza, poiché rende difficile per gli aggressori creare una collisione (due input diversi che producono lo stesso valore hash).
- Resistenza agli attacchi di collisione: Una funzione hash dovrebbe essere resistente agli attacchi di collisione, che implicano la ricerca di due input diversi che producono lo stesso valore hash. Gli attacchi di collisione possono essere utilizzati per creare firme digitali fraudolente o per aggirare i controlli di accesso, quindi è importante che una funzione hash sia progettata per resistervi.
Altre caratteristiche degli hash le puoi trovare nella pagina Wikipedia:https://en.wikipedia.org/wiki/Hash\_function
Verifica dei dati. Lista nera e lista bianca.
Nel contesto del software antivirus, gli algoritmi hash vengono utilizzati per rilevare malware o escludere avvisi di falsi positivi. Il software antivirus mantiene un database di hash malware noti (blacklist) e hash di software attendibili (whitelist). Quando un file viene scansionato, il suo hash viene confrontato con gli hash nel database.
Gli algoritmi hash più comunemente utilizzati per la verifica dei dati sono MD5, SHA-1, SHA-256 and SHA-512.
L'uso degli hash nelle blacklist e nelle whitelist degli antivirus aiuta ad accelerare il processo di scansione, poiché il programma antivirus non ha bisogno di eseguire un'analisi dettagliata di ciascun file per determinare se è dannoso o meno. Può invece confrontare i valori hash dei file con quelli presenti nella blacklist/whitelist per identificare rapidamente le minacce conosciute o le app attendibili.
Lista nera
Nel contesto della sicurezza informatica e del software antivirus, una lista nera è un elenco di file o parti di essi noti come dannosi. Quando un programma antivirus esegue la scansione di un computer o di una rete, confronta i file e le entità che incontra con la lista nera per identificare eventuali minacce. Se un file o un'entità corrisponde a una voce nella lista nera, il programma antivirus interverrà per rimuoverlo o metterlo in quarantena per evitare che possa causare danni.
Sebbene le liste nere possano essere utili per rilevare e prevenire minacce note, non sono sempre efficaci nella protezione da minacce nuove e sconosciute. Gli aggressori possono utilizzare varie tecniche, come l'offuscamento o il polimorfismo, per modificare il codice o il comportamento di un file o di un'entità per eludere il rilevamento da parte dei programmi antivirus.
Pertanto, i programmi antivirus utilizzano spesso una combinazione di tecniche, ad esempio whitelisting e rilevamento basato sul comportamento, per integrare l’uso delle liste nere e fornire una protezione più completa contro una gamma più ampia di minacce.
Lista bianca
Nel contesto della sicurezza informatica e del software antivirus, una whitelist è un elenco di file attendibili noti per essere sicuri. Se un file o un'entità corrisponde a una voce nella whitelist, il programma antivirus ne consentirà l'apertura/esecuzione senza intraprendere alcuna azione, poiché è considerato sicuro.
Le whitelist sono utili per prevenire falsi positivi nei programmi antivirus e di sicurezza. I falsi positivi si verificano quando un programma o un file viene contrassegnato come dannoso o dannoso quando in realtà è sicuro. Utilizzando una whitelist, i programmi di sicurezza possono aggirare questi falsi positivi, risparmiando tempo e prevenendo avvisi non necessari.
L'utilizzo di hash e blacklist/whitelist può essere un modo efficace per proteggersi dalle minacce note e prevenire falsi positivi nei programmi antivirus e di sicurezza.
Perché gli antivirus utilizzano diversi algoritmi hash?
I programmi antivirus utilizzano più algoritmi hash per diversi motivi:
- Resistenza agli attacchi di collisioneSebbene le liste nere possano essere efficaci nel rilevare e prevenire le minacce note, non sono infallibili. Gli aggressori possono utilizzare varie tecniche per eludere il rilevamento, come la modifica dei dati per evitare la corrispondenza con le firme nella lista nera. Queste tecniche sono chiamate “attacchi di collisione”. <br> Un attacco di collisione è un tipo di attacco crittografico in cui un utente malintenzionato tenta di trovare due input diversi, come file o messaggi, che producono lo stesso valore hash quando vengono eseguiti tramite una funzione hash (collisione). L'obiettivo di un attacco di collisione è creare una coppia di input che possono essere utilizzati per sovvertire un sistema che si basa sull'integrità dei valori hash, come firme digitali, autenticazione tramite password o controlli di integrità dei dati. Se un utente malintenzionato riesce a trovare una collisione, può sfruttarla per aggirare le misure di sicurezza che si basano sulla funzione hash. <br> Per mitigare il rischio di attacchi di collisione, gli antivirus utilizzano potenti funzioni hash resistenti agli attacchi e utilizzano diverse funzioni hash contemporaneamente. Ad esempio, se un programma antivirus utilizzasse solo l'algoritmo hash MD5, un utente malintenzionato potrebbe potenzialmente creare un file dannoso con lo stesso hash MD5 di un file legittimo e indurre il programma antivirus a considerare sicuro il file dannoso. Tuttavia, l’utilizzo di più algoritmi hash, come MD5, SHA-1 e SHA-256, rende più difficile per un utente malintenzionato creare un attacco di collisione che possa funzionare contro tutti gli algoritmi contemporaneamente.
- EfficienzaAlgoritmi hash diversi hanno requisiti computazionali diversi e alcuni potrebbero essere più efficienti di altri a seconda della dimensione del file, del tipo o di altri fattori. L'utilizzo di più algoritmi hash consente IA programmi antivirus di selezionare l'algoritmo più appropriato per una determinata situazione, il che può far risparmiare tempo e potenza di elaborazione. Ad esempio, SHA-256 potrebbe essere più impegnativo dal punto di vista computazionale rispetto a MD5, quindi un programma antivirus potrebbe scegliere di utilizzare MD5 per file più piccoli e SHA-256 per file più grandi.
- FlessibilitàDiversi algoritmi hash sono progettati per diversi casi d'uso e applicazioni. Utilizzando più algoritmi hash, i programmi antivirus possono adattarsi a diverse esigenze e scenari, come il rilevamento di malware, la verifica dell'integrità dei file o il rilevamento di manomissioni o modifiche. Ad esempio, un investigatore forense può utilizzare un algoritmo hash diverso rispetto a un programma antivirus per garantire che i dati non siano stati modificati durante un'indagine.
L'utilizzo di più algoritmi hash è una best practice nello sviluppo di software antivirus e di sicurezza informatica, poiché fornisce robustezza, compatibilità, efficienza e flessibilità nel rilevamento e nella prevenzione delle minacce informatiche.
Come fanno gli antivirus a riconoscere dati e file simili ma non identici?
File simili ma non identici possono rappresentare un problema di sicurezza informatica perché possono essere utilizzati dagli aggressori per eludere il rilevamento da parte del software antivirus.
Ad esempio, un utente malintenzionato può prendere un file malware noto e apportare lievi modifiche al suo codice o alla sua struttura, come cambiare i nomi delle variabili o riordinare le istruzioni. Queste modifiche possono essere sufficienti per creare un nuovo file simile ma non identico al file malware originale e che potrebbe non essere rilevato dal software antivirus che si basa sui tradizionali metodi di rilevamento basati su hash.
Inoltre, gli aggressori possono utilizzare file simili ma non identici per creare malware polimorfico, che può modificare il proprio codice o la propria struttura a ogni infezione per evitare il rilevamento. Il malware polimorfico può essere molto difficile da rilevare utilizzando le tecniche antivirus tradizionali, che si basano sul riconoscimento di modelli o firme specifici nel codice malware.
Per risolvere questo problema, utilizzano gli antivirus hash fuzzy.
L'hashing fuzzy è una tecnica utilizzata da alcuni software antivirus per rilevare file simili ma non identici, incluso il malware polimorfico. Suddividendo un file in parti più piccole e confrontando gli hash di tali parti con quelli di altri file, l'hashing fuzzy può identificare file che hanno codice o struttura simile, anche se non sono identici.
L'hashing fuzzy funziona identificando sequenze di byte che compaiono frequentemente nel file. Queste sequenze, note anche come "pezzi", vengono quindi sottoposte ad hashing utilizzando una funzione hash crittografica per generare un valore hash. I valori hash dei blocchi vengono quindi confrontati con quelli di altri file per identificare i blocchi simili.
Il vantaggio dell'hashing fuzzy è che può rilevare somiglianze anche quando i file sono stati modificati o offuscati, rendendolo un potente strumento per identificare varianti di malware noti. Ad esempio, se un utente malintenzionato modifica un file malware noto modificando i nomi di variabili o funzioni, i tradizionali metodi di rilevamento basati su hash potrebbero non rilevare il file modificato. Tuttavia, l'hashing fuzzy può comunque rilevare il file modificato identificando blocchi simili a quelli del file malware originale.
A differenza degli algoritmi di hashing crittografici come MD5, SHA-1 o SHA-512, gli algoritmi di hashing fuzzy producono valori hash di lunghezza variabile basati sulla somiglianza dei dati di input.
Vantaggi degli hash fuzzy
- Rilevamento di file simili: gli hash fuzzy possono rilevare file simili anche se sono stati leggermente modificati, il che è utile per identificare varianti di malware noti.
- Riduzione dei falsi positivi: Gli hash fuzzy possono ridurre il numero di falsi positivi generati dai tradizionali metodi di rilevamento basati su hash. Questo perché gli hash fuzzy possono rilevare file simili ma non identici a malware noti.
- Resilienza all'offuscamento: gli hash fuzzy sono più resistenti alle tecniche di offuscamento utilizzate dagli aggressori per eludere il rilevamento. Questo perché l'algoritmo di hashing fuzzy suddivide il file in parti più piccole e genera hash per ciascuna parte, rendendo più difficile per un utente malintenzionato modificare il file in modo da eludere il rilevamento.
Limitazioni dell'hashing fuzzy
- Falsi positivi: l'hashing fuzzy può produrre falsi positivi, in cui i file legittimi vengono contrassegnati come dannosi perché hanno un codice o una struttura simile a malware noto. Ciò può verificarsi se i file condividono librerie o framework comuni.
- Prestazione: L'hashing fuzzy può richiedere un utilizzo intensivo del calcolo, soprattutto per file di grandi dimensioni. Ciò può rallentare il processo di scansione e influire sulle prestazioni del sistema.
- Limitazioni di dimensione: L'hashing fuzzy potrebbe non funzionare bene su file molto piccoli o su file con bassa entropia, poiché potrebbero non esserci abbastanza blocchi univoci per generare hash significativi.
- Manomissione: l'hashing fuzzy potrebbe non essere efficace se un utente malintenzionato lo prende di mira specificamente e modifica un file per evitare il rilevamento. Ad esempio, un utente malintenzionato potrebbe modificare deliberatamente la struttura di un file per impedirne l'identificazione tramite hashing fuzzy.
Qual è la differenza tra algoritmi hash crittografici e algoritmi hash fuzzy?
Gli algoritmi di hash crittografico e gli algoritmi di hash fuzzy sono entrambi utilizzati nella sicurezza informatica, ma hanno scopi e caratteristiche diverse.
Gli algoritmi di hash crittografici, come SHA-256 e MD5, sono progettati per fornire integrità e autenticità dei dati generando valori hash univoci e di lunghezza fissa che sono quasi impossibili da decodificare. Gli algoritmi hash crittografici vengono utilizzati per verificare l'integrità dei dati.
Gli algoritmi di hash fuzzy, come SSDEEP, sono progettati per identificare dati simili ma non identici, come file che sono stati modificati o riconfezionati dagli autori di malware. L'hashing fuzzy utilizza una tecnica di finestra scorrevole per suddividere i dati in piccoli blocchi e generare hash probabilistici di lunghezza variabile che vengono confrontati con un database di hash malware noti per identificare file potenzialmente dannosi.
Gli algoritmi di hash crittografici sono progettati per essere resistenti alle collisioni, il che significa che è estremamente difficile trovare due input che producono lo stesso output di hash. Non è necessario che gli algoritmi di hash fuzzy siano resistenti alle collisioni poiché sono progettati per rilevare somiglianze tra file anziché produrre output hash univoci.
La principale differenza tra gli algoritmi di hash crittografico e gli algoritmi di hash fuzzy è il loro livello di determinismo. Gli algoritmi di hash crittografici producono hash deterministici a lunghezza fissa univoci per ciascun input, mentre gli algoritmi di hash fuzzy producono hash probabilistici a lunghezza variabile simili per input simili.
Quali algoritmi di hashing fuzzy utilizzeremo nella nostra soluzione?
Nella nostra soluzione utilizzeremo SSDEEP e TLSH.
ssdeep è un algoritmo di hashing fuzzy utilizzato per identificare dati simili ma non identici, come varianti di malware. Funziona generando un valore hash che rappresenta la somiglianza dei dati di input, piuttosto che un identificatore univoco come le funzioni hash crittografiche. L'output di ssdeep è di lunghezza variabile e probabilistico, il che gli consente di rilevare anche piccole differenze tra due file. ssdeep è comunemente utilizzato nell'analisi e nel rilevamento di malware ed è anche integrato in vari strumenti di sicurezza e software antivirus.
TLSH (Trend Micro Locality Sensitive Hash) è un algoritmo di hashing fuzzy utilizzato per identificare dati simili ma non identici, come varianti di malware. Funziona creando un valore hash che cattura le caratteristiche uniche dei dati di input, come la frequenza e l'ordine dei byte. L'output di TLSH è di lunghezza variabile e probabilistico, il che gli consente di rilevare somiglianze anche se i dati di input sono stati modificati o offuscati. TLSH è comunemente utilizzato nell'analisi e nel rilevamento di malware ed è anche integrato in vari strumenti di sicurezza e software antivirus.
ssdeep e TLSH utilizzano entrambi i parametri di distanza per determinare la somiglianza tra due valori hash. Tuttavia, i parametri di distanza utilizzati da ssdeep e TLSH sono diversi.
ssdeep utilizza la metrica "distanza hash fuzzy" per calcolare la distanza tra due valori hash. Questa metrica della distanza si basa sul numero di blocchi corrispondenti e non corrispondenti tra i due hash, nonché sulla dimensione degli hash. La metrica della distanza è un valore percentuale compreso tra 0 e 100, dove 0 significa che i due hash sono identici e 100 significa che i due hash sono completamente diversi.
TLSH, d'altra parte, utilizza la metrica "total diff" per calcolare la distanza tra due valori hash. Questa metrica della distanza si basa sulla differenza tra le caratteristiche sensibili alla località dei due set di dati di input. L'output della metrica "differenza totale" è un valore compreso tra 0 e 1000, dove 0 significa che i due valori hash sono identici e 1000 significa che i due valori hash sono completamente diversi.
Costruire il modulo di hashing
Per la nostra soluzione utilizzeremo le librerie open source:
- PolarSSL: https://polarssl.org/PolarSSL è una libreria software gratuita e open source per l'implementazione di protocolli crittografici come Transport Layer Security (TLS), Secure Sockets Layer (SSL), Datagram Transport Layer Security (DTLS). Fornisce vari algoritmi e protocolli crittografici, tra cui funzioni hash, crittografia simmetrica e asimmetrica, firme digitali e algoritmi di scambio di chiavi. PolarSSL è progettato per essere leggero ed efficiente, rendendolo adatto all'uso in ambienti con risorse limitate.
- ssdeep: http://ssdeep.sf.net/
- TLSH: https://github.com/trendmicro/tlsh/
Dopo aver implementato le librerie nel progetto, aggiungiamo un semplice codice:
struct HashData
{
 BYTE md5[16];
 BYTE sha1[20];
 BYTE sha512[64];
 std::string ssdeep;
 std::string tlsh;
};

HashData hash(const void* buff, uint64_t size)
{
 HashData snap = {};

 hashes::md5(buff, size, snap.md5);
 hashes::sha1(buff, size, snap.sha1);
 hashes::sha4(buff, size, snap.sha512);

 snap.ssdeep = hashes::ssdeepHash(buff, size);
 snap.tlsh = hashes::tlshHash(buff, size);

 return snap;
}
Controllo del modulo hashing
È ora di testare il modulo di hashing! Per fare ciò, creeremo un file di testo con il seguente contenuto:
All the World`s a Stage by William Shakespeare
All the world`s a stage,
And all the men and women merely players;
They have their exits and their entrances,
And one man in his time plays many parts,
His acts being seven ages. At first, the infant,
Mewling and puking in the nurse`s arms.
Then the whining schoolboy, with his satchel
And shining morning face, creeping like snail
Unwillingly to school. And then the lover,
Sighing like furnace, with a woeful ballad
Made to his mistress` eyebrow. Then a soldier,
Full of strange oaths and bearded like the pard,
Jealous in honor, sudden and quick in quarrel,
Seeking the bubble reputation
Even in the cannon`s mouth. And then the justice,
In fair round belly with good capon lined,
With eyes severe and beard of formal cut,
Full of wise saws and modern instances;
And so he plays his part. The sixth age shifts
Into the lean and slippered pantaloon,
With spectacles on nose and pouch on side;
His youthful hose, well saved, a world too wide
For his shrunk shank, and his big manly voice,
Turning again toward childish treble, pipes
And whistles in his sound. Last scene of all,
That ends this strange eventful history,
Is second childishness and mere oblivion,
Sans teeth, sans eyes, sans taste, sans everything.
TEST 1: crea due file identici con lo stesso contenuto (testo sopra) e calcola gli hash.


SSDEEP afferma che i file sono identici al 100%. TLSH afferma che ci sono differenze dello 0% tra i file.
TEST 2: Crea due file identici con lo stesso contenuto, apporta modifiche nel secondo file e calcola gli hash
Contenuto del secondo file:
All the World`s a Stage by William Shakespeare
O lovely maidens, fall in love,
But not with Muscovites,
For Muscovites are foreign folk,
They do not treat you right.
A Muscovite will love for sport,
And laughing go away;
They have their exits and their entrances,
And one man in his time plays many parts,
His acts being seven ages. At first, the infant,
Mewling and puking in the nurse`s arms.
Then the whining schoolboy, with his satchel
And shining morning face, creeping like snail
Unwillingly to school. And then the lover,
Sighing like furnace, with a woeful ballad
Made to his mistress` eyebrow. Then a soldier,
Full of strange oaths and bearded like the pard,
Jealous in honor, sudden and quick in quarrel,
Seeking the bubble reputation
Even in the cannon`s mouth. And then the justice,
In fair round belly with good capon lined,
With eyes severe and beard of formal cut,
Full of wise saws and modern instances;
And so he plays his part. The sixth age shifts
Into the lean and slippered pantaloon,
With spectacles on nose and pouch on side;
His youthful hose, well saved, a world too wide
For his shrunk shank, and his big manly voice,
Turning again toward childish treble, pipes
And whistles in his sound. Last scene of all,
That ends this strange eventful history,
Is second childishness and mere oblivion,
Sans teeth, sans eyes, sans taste, sans everything.

SSDEEP afferma che i file sono identici all'88%. TLSH afferma che ci sono differenze del 4,7% tra i file.
TEST 3: calcola gli hash per due file di testo completamente diversi
Contenuto del secondo file:
"Katerina", poem of Taras Shevchenko
(translated by John Weir)

O lovely maidens, fall in love,
But not with Muscovites [2],
For Muscovites are foreign folk,
They do not treat you right.
A Muscovite will love for sport,
And laughing go away;
He`ll go back to his Moscow land
And leave the maid a prey
To grief and shame...
It could be borne
If she were all alone,
But scorn is also heaped upon
Her mother frail and old.
The heart e`en languishing can sing –
For it knows how to wait;
But this the people do not see:
“A strumpet!“ they will say.
O lovely maidens, fall in love,
But not with Muscovites,
For Muscovites are foreign folk,
They leave you in a plight.
Young Katerina did not heed
Her parent`s warning words,
She fell in love with all her heart,
Forgetting all the world.

The orchard was their trysting-place;
She went there in the night
To meet her handsome Muscovite,
And thus she ruined her life.
Her anxious mother called and called
Her daughter home in vain;
There where her lover she caressed,
The whole night she remained.
Thus many nights she kissed her love
With passion strong and true,
The village gossips meanwhile hissed:
“A girl of ill repute!”
Let people talk, let gossips prate,
She does not even hear:
She is in love, that`s all she cares,
Nor feels disaster near.
Bad tidings came of strife with Turks,
The bugles blew one morn:
Her Muscovite went off to war,
And she remained at home.
A kerchief o`er her braids they placed
To show she`s not a maid,
But Katerina does not mind,
Her lover she awaits.
He promised her that he’d return
If he was left alive,
That he`d come back after the war –
And then she`d be his wife,
An army bride, a Muscovite
Herself, her ills forgot,
And if in meantime people prate,
Well, let the people talk!
She does not worry, not a bit –
The reason that she weeps
Is that the girls at sundown sing
Without her on the streets.
No, Katerina does not fret –
And jet her eyelids swell,
And she at midnight goes to fetch

The water from the well
So that she won`t by foes be seen;
When to the well she comes,
She stands beneath the snowball-tree
And sings such mournful songs,
Such songs of misery and grief,
The rose .itself must weep.
Then she comes home - content that she
By neighbours was not seen.
No, Katerina does not fret.
She`s carefree as can be -
With her new kerchief on her head
She looks out on the street.
So at the window day by day
Six months she sat in vain....
With sickness then was overcome,
Her body racked with pain.
Her illness very grievous proved.
She barely breathed for days ...
When it was over - by the stove
She rocked her tiny babe.
The gossips` tongues now got free rein.
The other mothers jibed
That soldiers marching home again
At her house spent the night.
“Oh, you have reared a daughter fair.
And not alone beside
The stove she sits - she`s drilling there
A little Muscovite.
She found herself a brown-eyed son...
You must have taught her how!...
Oh fie on ye, ye prattle tongues,
I hope yourselves you`ll feel
Someday such pains as she who bore
A son that you should jeer!
Oh, Katerina, my poor dear!
How cruel a fate is thine!

SSDEEP afferma che i file sono completamente diversi, con corrispondenze dello 0%. Tuttavia, TLSH afferma che i file sono diversi solo al 27,1%.
Perché? Dopotutto, consideriamo la distanza tra due file di testo completamente diversi, giusto?
Il fatto è che, come abbiamo detto sopra, l'algoritmo TLSH tiene conto delle frequenze. Nonostante i testi siano diversi, tuttavia sono scritti nella stessa lingua, usano lo stesso alfabeto e contengono molte delle stesse parole. Questa funzionalità di questo algoritmo di hashing aiuta a rilevare le modifiche dei file dannosi.
TEST 4: confronta 2 file di sistema Windows.

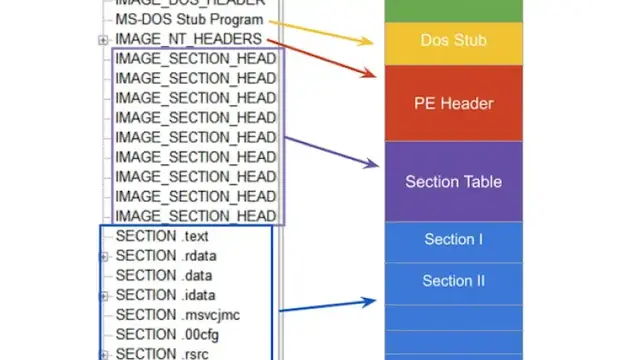
SSDEEP afferma che i file sono completamente diversi, con corrispondenze dello 0%. Tuttavia, l’algoritmo TLSH afferma che i file differiscono solo del 14,5%. Ciò è in parte dovuto al fatto che molto probabilmente i file sono stati creati dallo stesso compilatore, dalla stessa azienda, possibilmente utilizzando gli stessi modelli di codice. I file hanno intestazioni VERSION_INFO e MZ simili.
TEST 5: confronta 2 file di sistema e il nostro file hashpair.exe

SSDEEP afferma che i file sono completamente diversi, con corrispondenze dello 0%. L'algoritmo TLSH afferma che i file differiscono in modo significativo, del 73,3%. Questi file sono stati compilati da diverse società, utilizzando diverse librerie e diversi compilatori. Questi file hanno intestazioni VERSION_INFO e MZ diverse. Pertanto, l'algoritmo TLSH consente di classificare i file eseguibili, aiutando a identificare file dannosi simili o file dannosi della stessa famiglia.
Elenco degli strumenti utilizzati
- WinMerge: https://winmerge.orgWinMerge è uno strumento di differenziazione e fusione Open Source per Windows. WinMerge può confrontare sia cartelle che file, presentando le differenze in un formato di testo visivo facile da comprendere e gestire.
- Blocco note++: https://notepad-plus-plus.org/downloadsNotepad++ è un editor di codice sorgente gratuito (come in “libertà di parola” e anche come in “birra gratis”) e un sostituto del Blocco note che supporta diverse lingue. In esecuzione nell'ambiente MS Windows, il suo utilizzo è regolato dalla GNU General Public License.
GITHUB
Puoi trovare il codice dell'intero progetto sul nostro github:https://github.com/SToFU-Systems/DSAVE
COSA C'È DOPO?
Apprezziamo il tuo supporto e attendiamo con ansia il tuo continuo impegno nella nostra comunità.
Nel prossimo articolo scriveremo insieme a te il più semplice parser di risorse PE.
Eventuali domande degli autori dell'articolo possono essere inviate all'e-mail: articoli@stofu.io
Grazie per l'attenzione e buona giornata!