Hash
Em primeiro lugar, vamos examinar o básico e nos familiarizar com um conceito como hash!
Algoritmo hash é uma função matemática que recebe dados de qualquer tamanho e produz uma saída chamada hash or resumo da mensagem. A saída é uma representação exclusiva dos dados de entrada, que pode ser usada para verificar se os dados não foram adulterados. Algoritmos hash são usados para garantir a integridade e autenticidade dos dados.
Em termos simples, um hash é uma impressão digital única de um dado. É como um código que representa os dados. O código é gerado por uma função matemática chamada função hash. Se os dados mudarem um pouco, o hash será diferente.
Existem características-chave primárias para hash:
- Determinístico: Uma função hash deve sempre produzir a mesma saída para uma determinada entrada. Isso significa que se você fizer hash dos mesmos dados duas vezes, deverá obter o mesmo valor de hash nas duas vezes.
- Irreversibilidade: Deve ser computacionalmente inviável reconstruir os dados de entrada originais a partir de seu valor hash. Esta propriedade é importante para a segurança, pois protege os dados originais de serem descobertos por invasores que só têm acesso ao valor do hash.
- Uniformidade: Uma função hash deve produzir uma distribuição uniforme de valores hash em todas as entradas possíveis. Isso significa que cada valor de hash deve ter a mesma probabilidade de ocorrer e não deve haver padrões ou distorções na distribuição dos valores de hash.
- Imprevisibilidade: Deve ser computacionalmente inviável prever o valor hash de uma entrada com base nos valores hash de outras entradas ou nas propriedades da própria função hash. Esta propriedade é importante para a segurança, pois dificulta que invasores criem uma colisão (duas entradas diferentes que produzem o mesmo valor de hash).
- Resistência a ataques de colisão: Uma função hash deve ser resistente a ataques de colisão, que envolvem encontrar duas entradas diferentes que produzem o mesmo valor hash. Os ataques de colisão podem ser usados para criar assinaturas digitais fraudulentas ou para contornar os controles de acesso, por isso é importante que uma função hash seja projetada para resistir a eles.
Outras características dos hashes que você pode encontrar na página da Wikipedia:https://en.wikipedia.org/wiki/Hash\_function
Verificação de dados. Lista negra e lista branca.
No contexto do software antivírus, algoritmos hash são usados para detectar malware ou excluir alertas falsos positivos. O software antivírus mantém um banco de dados de hashes de malware conhecidos (blacklist) e hashes de software confiáveis (whitelist). Quando um arquivo é verificado, seu hash é comparado aos hashes do banco de dados.
Os algoritmos hash mais comumente usados para verificação de dados são MD5, SHA-1, SHA-256 and SHA-512.
O uso de hashes em listas negras e brancas de antivírus ajuda a agilizar o processo de verificação, já que o programa antivírus não precisa realizar uma análise detalhada de cada arquivo para determinar se ele é malicioso ou não. Em vez disso, ele pode comparar os valores de hash dos arquivos com os da lista negra/lista branca para identificar rapidamente ameaças conhecidas ou aplicativos confiáveis.
Lista negra
No contexto da segurança cibernética e do software antivírus, uma lista negra é uma lista de arquivos maliciosos conhecidos ou partes desses arquivos. Quando um programa antivírus verifica um computador ou rede, ele compara os arquivos e entidades que encontra com a lista negra para identificar quaisquer ameaças. Se um arquivo ou entidade corresponder a uma entrada na lista negra, o programa antivírus tomará medidas para removê-lo ou colocá-lo em quarentena para evitar que cause danos.
Embora as listas negras possam ser úteis na detecção e prevenção de ameaças conhecidas, elas nem sempre são eficazes na proteção contra ameaças novas e desconhecidas. Os invasores podem usar diversas técnicas, como ofuscação ou polimorfismo, para modificar o código ou o comportamento de um arquivo ou entidade para evitar a detecção por programas antivírus.
Portanto, os programas antivírus costumam usar uma combinação de técnicas, como whitelisting e detecção baseada em comportamento, para complementar o uso de listas negras e fornecer proteção mais abrangente contra uma gama mais ampla de ameaças.
Lista de permissões
No contexto da segurança cibernética e do software antivírus, uma lista de permissões é uma lista de arquivos confiáveis que são conhecidos por serem seguros. Se um arquivo ou entidade corresponder a uma entrada na lista de permissões, o programa antivírus permitirá que ele seja aberto/executado sem realizar nenhuma ação, pois é considerado seguro.
As listas de permissões são úteis na prevenção de falsos positivos em programas antivírus e de segurança. Falsos positivos ocorrem quando um programa ou arquivo é sinalizado como malicioso ou prejudicial, quando na verdade é seguro. Ao usar uma lista de permissões, os programas de segurança podem contornar esses falsos positivos, o que pode economizar tempo e evitar alertas desnecessários.
Usar hashes e listas negras/listas brancas pode ser uma forma eficaz de proteção contra ameaças conhecidas e evitar falsos positivos em antivírus e programas de segurança.
Por que os antivírus usam vários algoritmos de hash?
Os programas antivírus usam vários algoritmos de hash por vários motivos:
- Resistência ao ataque de colisãoEmbora as listas negras possam ser eficazes na detecção e prevenção de ameaças conhecidas, elas não são infalíveis. Os invasores podem usar várias técnicas para evitar a detecção, como modificar os dados para evitar a correspondência das assinaturas na lista negra. Essas técnicas são denominadas “ataques de colisão”. <br> Um ataque de colisão é um tipo de ataque criptográfico em que um invasor tenta encontrar duas entradas diferentes, como arquivos ou mensagens, que produzem o mesmo valor de hash quando executadas por meio de uma função hash (colisão). O objetivo de um ataque de colisão é criar um par de entradas que possam ser usadas para subverter um sistema que depende da integridade de valores hash, como assinaturas digitais, autenticação de senha ou verificações de integridade de dados. Se um invasor conseguir encontrar uma colisão, ele poderá usá-la para contornar as medidas de segurança que dependem da função hash. <br> Para mitigar o risco de ataques de colisão, os antivírus usam funções hash fortes que são resistentes a ataques e usam diversas funções hash simultaneamente. Por exemplo, se um programa antivírus usasse apenas o algoritmo de hash MD5, um invasor poderia criar um arquivo malicioso que tivesse o mesmo hash MD5 de um arquivo legítimo e enganar o programa antivírus para que tratasse o arquivo malicioso como seguro. No entanto, o uso de vários algoritmos de hash, como MD5, SHA-1 e SHA-256, torna mais difícil para um invasor criar um ataque de colisão que funcione contra todos os algoritmos simultaneamente.
- EficiênciaDiferentes algoritmos de hash têm diferentes requisitos computacionais e alguns podem ser mais eficientes que outros, dependendo do tamanho, tipo ou outros fatores do arquivo. O uso de vários algoritmos hash permite que os programas antivírus selecionem o algoritmo mais apropriado para uma determinada situação, o que pode economizar tempo e poder de processamento. Por exemplo, o SHA-256 pode ser mais intensivo em termos computacionais do que o MD5, portanto, um programa antivírus pode optar por usar o MD5 para arquivos menores e o SHA-256 para arquivos maiores.
- FlexibilidadeDiferentes algoritmos de hash são projetados para diferentes casos de uso e aplicações. Ao usar vários algoritmos de hash, os programas antivírus podem se adaptar a diferentes necessidades e cenários, como detecção de malware, verificação da integridade de arquivos ou detecção de adulteração ou modificação. Por exemplo, um investigador forense pode usar um algoritmo de hash diferente de um programa antivírus para garantir que os dados não foram modificados durante uma investigação.
O uso de vários algoritmos hash é uma prática recomendada no desenvolvimento de software antivírus e de segurança cibernética, pois fornece robustez, compatibilidade, eficiência e flexibilidade na detecção e prevenção de ameaças cibernéticas.
Como os antivírus reconhecem dados e arquivos semelhantes, mas não idênticos?
Arquivos semelhantes, mas não idênticos, podem ser um problema de segurança cibernética porque podem ser usados por invasores para evitar a detecção por software antivírus.
Por exemplo, um invasor pode pegar um arquivo de malware conhecido e fazer pequenas modificações em seu código ou estrutura, como alterar nomes de variáveis ou reordenar instruções. Essas modificações podem ser suficientes para criar um novo arquivo semelhante, mas não idêntico ao arquivo de malware original, e que pode não ser detectado por software antivírus que depende de métodos tradicionais de detecção baseados em hash.
Além disso, os invasores podem usar arquivos semelhantes, mas não idênticos, para criar malware polimórfico, que pode alterar seu código ou estrutura a cada infecção para evitar a detecção. O malware polimórfico pode ser muito difícil de detectar usando técnicas antivírus tradicionais, que dependem do reconhecimento de padrões ou assinaturas específicas no código do malware.
Para resolver este problema, os antivírus usam hashes difusos.
Hashing difuso é uma técnica usada por alguns softwares antivírus para detectar arquivos semelhantes, mas não idênticos, incluindo malware polimórfico. Ao dividir um arquivo em partes menores e comparar os hashes dessas partes com os de outros arquivos, o hash difuso pode identificar arquivos que possuem código ou estrutura semelhante, mesmo que não sejam idênticos.
O hash difuso funciona identificando sequências de bytes que aparecem com frequência no arquivo. Essas sequências, também conhecidas como “pedaços”, são então hash usando uma função hash criptográfica para gerar um valor hash. Os valores de hash dos pedaços são então comparados com os de outros arquivos para identificar pedaços semelhantes.
A vantagem do hash difuso é que ele pode detectar semelhanças mesmo quando os arquivos foram modificados ou ofuscados, tornando-o uma ferramenta poderosa para identificar variantes de malware conhecido. Por exemplo, se um invasor modificar um arquivo de malware conhecido alterando os nomes de variáveis ou funções, os métodos tradicionais de detecção baseados em hash poderão não detectar o arquivo modificado. No entanto, o hash difuso ainda pode detectar o arquivo modificado, identificando pedaços semelhantes aos do arquivo de malware original.
Ao contrário dos algoritmos de hash criptográfico como MD5, SHA-1 ou SHA-512, os algoritmos de hash difuso produzem valores de hash de comprimento variável baseados na similaridade dos dados de entrada.
Vantagens de hashes difusos
- Detecção de arquivos semelhantes: hashes difusos podem detectar arquivos semelhantes mesmo que tenham sido ligeiramente modificados, o que é útil para identificar variantes de malware conhecido.
- Falsos positivos reduzidos: Hashes difusos podem reduzir o número de falsos positivos gerados por métodos tradicionais de detecção baseados em hash. Isso ocorre porque hashes difusos podem detectar arquivos semelhantes, mas não idênticos, a malwares conhecidos.
- Resiliência à ofuscação: hashes difusos são mais resistentes às técnicas de ofuscação usadas pelos invasores para evitar a detecção. Isso ocorre porque o algoritmo de hash difuso divide o arquivo em pedaços menores e gera hashes para cada pedaço, tornando mais difícil para um invasor modificar o arquivo de uma forma que evite a detecção.
Limitações do hash difuso
- Falsos positivos: o hash difuso pode produzir falsos positivos, onde arquivos legítimos são sinalizados como maliciosos porque possuem código ou estrutura semelhante a malware conhecido. Isso poderá ocorrer se os arquivos compartilharem bibliotecas ou estruturas comuns.
- Desempenho: o hash difuso pode ser computacionalmente intensivo, especialmente para arquivos grandes. Isso pode retardar o processo de digitalização e afetar o desempenho do sistema.
- Limitações de tamanho: o hash difuso pode não funcionar bem em arquivos muito pequenos ou com baixa entropia, pois pode não haver pedaços únicos suficientes para gerar hashes significativos.
- Adulteração: o hash difuso pode não ser eficaz se um invasor o atingir especificamente e modificar um arquivo para evitar a detecção. Por exemplo, um invasor pode alterar deliberadamente a estrutura de um arquivo para evitar que ele seja identificado por hash difuso.
Qual é a diferença entre algoritmos de hash criptográfico e algoritmos de hash difusos?
Algoritmos de hash criptográfico e algoritmos de hash fuzzy são usados em segurança cibernética, mas têm finalidades e características diferentes.
Algoritmos de hash criptográficos, como SHA-256 e MD5, são projetados para fornecer integridade e autenticidade de dados, gerando valores de hash exclusivos e de comprimento fixo que são quase impossíveis de fazer engenharia reversa. Algoritmos de hash criptográfico são usados para verificar a integridade dos dados.
Algoritmos de hash difusos, como SSDEEP, são projetados para identificar dados semelhantes, mas não idênticos, como arquivos que foram modificados ou reembalados por autores de malware. O hash difuso usa uma técnica de janela deslizante para dividir os dados em pequenos pedaços e gerar hashes probabilísticos de comprimento variável que são comparados com um banco de dados de hashes de malware conhecidos para identificar arquivos potencialmente maliciosos.
Os algoritmos de hash criptográfico são projetados para serem resistentes a colisões, o que significa que é extremamente difícil encontrar duas entradas que produzam a mesma saída de hash. Os algoritmos de hash fuzzy não precisam ser resistentes a colisões, pois são projetados para detectar semelhanças entre arquivos, em vez de produzir saídas de hash exclusivas.
A principal diferença entre algoritmos de hash criptográfico e algoritmos de hash fuzzy é o seu nível de determinismo. Algoritmos de hash criptográfico produzem hashes determinísticos de comprimento fixo que são exclusivos para cada entrada, enquanto algoritmos de hash fuzzy produzem hashes probabilísticos de comprimento variável que são semelhantes para entradas semelhantes.
Quais algoritmos de hash difuso usaremos em nossa solução?
Em nossa solução usaremos SSDEEP e TLSH.
ssdeep é um algoritmo de hash difuso usado para identificar dados semelhantes, mas não idênticos, como variantes de malware. Ele funciona gerando um valor hash que representa a similaridade dos dados de entrada, em vez de um identificador exclusivo, como funções hash criptográficas. A saída do ssdeep tem comprimento variável e é probabilística, o que permite detectar até mesmo pequenas diferenças entre dois arquivos. ssdeep é comumente usado na análise e detecção de malware e também está integrado a várias ferramentas de segurança e software antivírus.
TLSH (Trend Micro Locality Sensitive Hash) é um algoritmo de hash difuso usado para identificar dados semelhantes, mas não idênticos, como variantes de malware. Ele funciona criando um valor hash que captura os recursos exclusivos dos dados de entrada, como frequência e ordem de bytes. A saída do TLSH é de comprimento variável e probabilística, o que permite detectar semelhanças mesmo que os dados de entrada tenham sido modificados ou ofuscados. O TLSH é comumente usado na análise e detecção de malware e também está integrado a várias ferramentas de segurança e software antivírus.
ssdeep e TLSH usam métricas de distância para determinar a semelhança entre dois valores de hash. No entanto, as métricas de distância usadas por ssdeep e TLSH são diferentes.
ssdeep usa a métrica "distância de hash difusa" para calcular a distância entre dois valores de hash. Essa métrica de distância é baseada no número de blocos correspondentes e não correspondentes entre os dois hashes, bem como no tamanho dos hashes. A métrica de distância é um valor percentual que varia de 0 a 100, onde 0 significa que os dois hashes são idênticos e 100 significa que os dois hashes são completamente diferentes.
O TLSH, por outro lado, usa a métrica “diferença total” para calcular a distância entre dois valores de hash. Esta métrica de distância é baseada na diferença entre os recursos sensíveis à localidade dos dois conjuntos de dados de entrada. A saída da métrica "diferença total" é um valor entre 0 e 1000, onde 0 significa que os dois valores de hash são idênticos e 1000 significa que os dois valores de hash são completamente diferentes.
Construindo o módulo de hash
Para nossa solução, usaremos bibliotecas de código aberto:
- PolarSSL: https://polarssl.org/PolarSSL é uma biblioteca de software gratuita e de código aberto para implementação de protocolos criptográficos como Transport Layer Security (TLS), Secure Sockets Layer (SSL), Datagram Transport Layer Security (DTLS). Ele fornece vários algoritmos e protocolos criptográficos, incluindo funções hash, criptografia simétrica e assimétrica, assinaturas digitais e algoritmos de troca de chaves. O PolarSSL foi projetado para ser leve e eficiente, tornando-o adequado para uso em ambientes com recursos limitados.
- ssdeep: http://ssdeep.sf.net/
- TLSH: https://github.com/trendmicro/tlsh/
Após implementar as bibliotecas no projeto, adicionamos um código simples:
struct HashData
{
 BYTE md5[16];
 BYTE sha1[20];
 BYTE sha512[64];
 std::string ssdeep;
 std::string tlsh;
};

HashData hash(const void* buff, uint64_t size)
{
 HashData snap = {};

 hashes::md5(buff, size, snap.md5);
 hashes::sha1(buff, size, snap.sha1);
 hashes::sha4(buff, size, snap.sha512);

 snap.ssdeep = hashes::ssdeepHash(buff, size);
 snap.tlsh = hashes::tlshHash(buff, size);

 return snap;
}
Verificando o módulo de hash
É hora de testar o módulo de hashing! Para fazer isso, criaremos um arquivo de texto com o seguinte conteúdo:
All the World`s a Stage by William Shakespeare
All the world`s a stage,
And all the men and women merely players;
They have their exits and their entrances,
And one man in his time plays many parts,
His acts being seven ages. At first, the infant,
Mewling and puking in the nurse`s arms.
Then the whining schoolboy, with his satchel
And shining morning face, creeping like snail
Unwillingly to school. And then the lover,
Sighing like furnace, with a woeful ballad
Made to his mistress` eyebrow. Then a soldier,
Full of strange oaths and bearded like the pard,
Jealous in honor, sudden and quick in quarrel,
Seeking the bubble reputation
Even in the cannon`s mouth. And then the justice,
In fair round belly with good capon lined,
With eyes severe and beard of formal cut,
Full of wise saws and modern instances;
And so he plays his part. The sixth age shifts
Into the lean and slippered pantaloon,
With spectacles on nose and pouch on side;
His youthful hose, well saved, a world too wide
For his shrunk shank, and his big manly voice,
Turning again toward childish treble, pipes
And whistles in his sound. Last scene of all,
That ends this strange eventful history,
Is second childishness and mere oblivion,
Sans teeth, sans eyes, sans taste, sans everything.
TESTE 1: crie dois arquivos idênticos com o mesmo conteúdo (texto acima) e calcule hashes.


SSDEEP diz que os arquivos são 100% idênticos. TLSH diz que há diferenças de 0% entre os arquivos.
TESTE 2: Crie dois arquivos idênticos com o mesmo conteúdo, faça alterações no segundo arquivo e calcule hashes
Conteúdo do segundo arquivo:
All the World`s a Stage by William Shakespeare
O lovely maidens, fall in love,
But not with Muscovites,
For Muscovites are foreign folk,
They do not treat you right.
A Muscovite will love for sport,
And laughing go away;
They have their exits and their entrances,
And one man in his time plays many parts,
His acts being seven ages. At first, the infant,
Mewling and puking in the nurse`s arms.
Then the whining schoolboy, with his satchel
And shining morning face, creeping like snail
Unwillingly to school. And then the lover,
Sighing like furnace, with a woeful ballad
Made to his mistress` eyebrow. Then a soldier,
Full of strange oaths and bearded like the pard,
Jealous in honor, sudden and quick in quarrel,
Seeking the bubble reputation
Even in the cannon`s mouth. And then the justice,
In fair round belly with good capon lined,
With eyes severe and beard of formal cut,
Full of wise saws and modern instances;
And so he plays his part. The sixth age shifts
Into the lean and slippered pantaloon,
With spectacles on nose and pouch on side;
His youthful hose, well saved, a world too wide
For his shrunk shank, and his big manly voice,
Turning again toward childish treble, pipes
And whistles in his sound. Last scene of all,
That ends this strange eventful history,
Is second childishness and mere oblivion,
Sans teeth, sans eyes, sans taste, sans everything.

SSDEEP diz que os arquivos são 88% idênticos. TLSH diz que há diferenças de 4,7% entre os arquivos.
TESTE 3: calcule hashes para dois arquivos de texto completamente diferentes
Conteúdo do segundo arquivo:
"Katerina", poem of Taras Shevchenko
(translated by John Weir)

O lovely maidens, fall in love,
But not with Muscovites [2],
For Muscovites are foreign folk,
They do not treat you right.
A Muscovite will love for sport,
And laughing go away;
He`ll go back to his Moscow land
And leave the maid a prey
To grief and shame...
It could be borne
If she were all alone,
But scorn is also heaped upon
Her mother frail and old.
The heart e`en languishing can sing –
For it knows how to wait;
But this the people do not see:
“A strumpet!“ they will say.
O lovely maidens, fall in love,
But not with Muscovites,
For Muscovites are foreign folk,
They leave you in a plight.
Young Katerina did not heed
Her parent`s warning words,
She fell in love with all her heart,
Forgetting all the world.

The orchard was their trysting-place;
She went there in the night
To meet her handsome Muscovite,
And thus she ruined her life.
Her anxious mother called and called
Her daughter home in vain;
There where her lover she caressed,
The whole night she remained.
Thus many nights she kissed her love
With passion strong and true,
The village gossips meanwhile hissed:
“A girl of ill repute!”
Let people talk, let gossips prate,
She does not even hear:
She is in love, that`s all she cares,
Nor feels disaster near.
Bad tidings came of strife with Turks,
The bugles blew one morn:
Her Muscovite went off to war,
And she remained at home.
A kerchief o`er her braids they placed
To show she`s not a maid,
But Katerina does not mind,
Her lover she awaits.
He promised her that he’d return
If he was left alive,
That he`d come back after the war –
And then she`d be his wife,
An army bride, a Muscovite
Herself, her ills forgot,
And if in meantime people prate,
Well, let the people talk!
She does not worry, not a bit –
The reason that she weeps
Is that the girls at sundown sing
Without her on the streets.
No, Katerina does not fret –
And jet her eyelids swell,
And she at midnight goes to fetch

The water from the well
So that she won`t by foes be seen;
When to the well she comes,
She stands beneath the snowball-tree
And sings such mournful songs,
Such songs of misery and grief,
The rose .itself must weep.
Then she comes home - content that she
By neighbours was not seen.
No, Katerina does not fret.
She`s carefree as can be -
With her new kerchief on her head
She looks out on the street.
So at the window day by day
Six months she sat in vain....
With sickness then was overcome,
Her body racked with pain.
Her illness very grievous proved.
She barely breathed for days ...
When it was over - by the stove
She rocked her tiny babe.
The gossips` tongues now got free rein.
The other mothers jibed
That soldiers marching home again
At her house spent the night.
“Oh, you have reared a daughter fair.
And not alone beside
The stove she sits - she`s drilling there
A little Muscovite.
She found herself a brown-eyed son...
You must have taught her how!...
Oh fie on ye, ye prattle tongues,
I hope yourselves you`ll feel
Someday such pains as she who bore
A son that you should jeer!
Oh, Katerina, my poor dear!
How cruel a fate is thine!

SSDEEP diz que os arquivos são completamente diferentes, com 0% de correspondências. No entanto, o TLSH afirma que os arquivos são apenas 27,1% diferentes.
Por que isso? Afinal, consideramos a distância entre dois arquivos de texto completamente diferentes, certo?
Acontece que, como dissemos acima, o algoritmo TLSH leva em consideração as frequências. Apesar de os textos serem diferentes, eles são escritos na mesma língua, usam o mesmo alfabeto e possuem várias palavras iguais. Este recurso deste algoritmo de hash ajuda a detectar modificações de arquivos maliciosos.
TESTE 4: compare 2 arquivos de sistema Windows

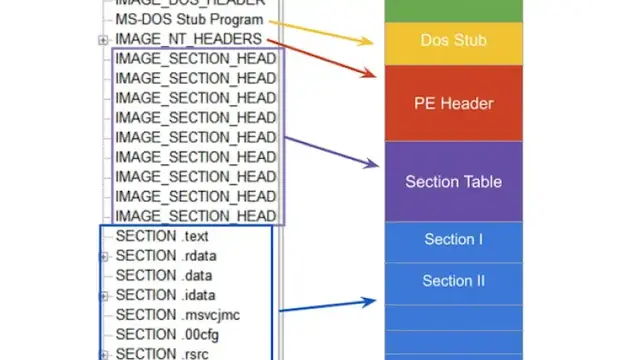
SSDEEP diz que os arquivos são completamente diferentes, com 0% de correspondências. No entanto, o algoritmo TLSH diz que os arquivos diferem em apenas 14,5%. Isto se deve em parte ao fato de que muito provavelmente os arquivos foram construídos pelo mesmo compilador, pela mesma empresa, possivelmente usando os mesmos padrões de código. Os arquivos têm cabeçalhos VERSION_INFO e MZ semelhantes.
TESTE 5: compare 2 arquivos de sistema e nosso arquivo hashpair.exe

SSDEEP diz que os arquivos são completamente diferentes, com 0% de correspondências. O algoritmo TLSH diz que os arquivos diferem significativamente, em 73,3%. Esses arquivos foram compilados por diferentes empresas, utilizando diferentes bibliotecas e diferentes compiladores. Esses arquivos têm VERSION_INFO diferentes e cabeçalhos MZ diferentes. Assim, o algoritmo TLSH permite categorizar arquivos executáveis, ajudando a identificar arquivos maliciosos semelhantes ou arquivos maliciosos da mesma família.
Lista de ferramentas usadas
- WinMerge: https://winmerge.orgWinMerge é uma ferramenta de diferenciação e fusão de código aberto para Windows. WinMerge pode comparar pastas e arquivos, apresentando diferenças em um formato de texto visual fácil de entender e manusear.
- Bloco de notas++: https://notepad-plus-plus.org/downloadsNotepad++ é um editor de código-fonte gratuito (como em “liberdade de expressão” e também em “cerveja grátis”) e substituto do bloco de notas que suporta vários idiomas. Executando no ambiente MS Windows, seu uso é regido pela GNU General Public License.
GITHUB
Você pode encontrar o código de todo o projeto em nosso github:https://github.com/SToFU-Systems/DSAVE
O QUE SE SEGUE?
Agradecemos seu apoio e esperamos seu envolvimento contínuo em nossa comunidade.
No próximo artigo escreveremos junto com você o analisador de recursos PE mais simples.
Qualquer dúvida dos autores do artigo pode ser enviada para o e-mail: articles@stofu.io
Obrigado pela atenção e tenha um bom dia!