picadillo
En primer lugar, repasemos los conceptos básicos y familiaricémonos con el concepto de hash.
Algoritmo hash es una función matemática que toma datos de cualquier tamaño y produce una salida llamada hash or resumen del mensaje. La salida es una representación única de los datos de entrada, que se puede utilizar para verificar que los datos no hayan sido manipulados. Los algoritmos hash se utilizan para garantizar la integridad y autenticidad de los datos.
En términos simples, un hash es una huella digital única de un dato. Es como un código que representa los datos. El código es generado por una función matemática llamada función hash. Si los datos cambian aunque sea un poquito, el hash será diferente.
Existen características clave principales para el hachís:
- determinista: Una función hash siempre debe producir la misma salida para una entrada determinada. Esto significa que si aplica hash a los mismos datos dos veces, debería obtener el mismo valor hash en ambas ocasiones.
- Irreversibilidad: Debería ser computacionalmente inviable reconstruir los datos de entrada originales a partir de su valor hash. Esta propiedad es importante para la seguridad, ya que protege los datos originales para que no sean descubiertos por atacantes que solo tienen acceso al valor hash.
- Uniformidad: Una función hash debe producir una distribución uniforme de valores hash en todas las entradas posibles. Esto significa que cada valor hash debe tener la misma probabilidad de ocurrir y no debe haber patrones ni sesgos en la distribución de los valores hash.
- Imprevisibilidad: Debería ser computacionalmente inviable predecir el valor hash de una entrada en función de los valores hash de otras entradas o de las propiedades de la función hash misma. Esta propiedad es importante para la seguridad, ya que dificulta que los atacantes creen una colisión (dos entradas diferentes que producen el mismo valor hash).
- Resistencia a los ataques de colisión.: Una función hash debe ser resistente a los ataques de colisión, que implican encontrar dos entradas diferentes que produzcan el mismo valor hash. Los ataques de colisión se pueden utilizar para crear firmas digitales fraudulentas o para eludir los controles de acceso, por lo que es importante que se diseñe una función hash para resistirlos.
Otras características de los hashes las puedes encontrar en la página de Wikipedia:https://en.wikipedia.org/wiki/Hash\_function
Verificación de datos. Lista negra y lista blanca.
En el contexto del software antivirus, los algoritmos hash se utilizan para detectar malware o excluir alertas falsas positivas. El software antivirus mantiene una base de datos de hashes de malware conocidos (blacklist) y hash de software confiable (whitelist). Cuando se escanea un archivo, su hash se compara con los hashes de la base de datos.
Los algoritmos hash más utilizados para la verificación de datos son MD5, SHA-1, SHA-256 and SHA-512.
El uso de hashes en las listas blancas y negras de antivirus ayuda a acelerar el proceso de escaneo, ya que el programa antivirus no necesita realizar un análisis detallado de cada archivo para determinar si es malicioso o no. En cambio, puede comparar los valores hash de los archivos con los de la lista negra o blanca para identificar rápidamente amenazas conocidas o aplicaciones confiables.
Lista negra
En el contexto de la ciberseguridad y el software antivirus, una lista negra es una lista de archivos maliciosos conocidos o partes de estos archivos. Cuando un programa antivirus escanea una computadora o red, compara los archivos y entidades que encuentra con la lista negra para identificar cualquier amenaza. Si un archivo o entidad coincide con una entrada en la lista negra, el programa antivirus tomará medidas para eliminarlo o ponerlo en cuarentena para evitar que cause daños.
Si bien las listas negras pueden ser útiles para detectar y prevenir amenazas conocidas, no siempre son efectivas para proteger contra amenazas nuevas y desconocidas. Los atacantes pueden utilizar diversas técnicas, como ofuscación o polimorfismo, para modificar el código o el comportamiento de un archivo o entidad para evadir la detección de los programas antivirus.
Por lo tanto, los programas antivirus suelen utilizar una combinación de técnicas, como whitelisting y detección basada en comportamiento, para complementar el uso de listas negras y proporcionar una protección más completa contra una gama más amplia de amenazas.
Lista blanca
En el contexto de la ciberseguridad y el software antivirus, una lista blanca es una lista de archivos confiables que se sabe que son seguros. Si un archivo o entidad coincide con una entrada en la lista blanca, el programa antivirus permitirá que se abra/ejecute sin realizar ninguna acción, ya que se considera seguro.
Las listas blancas son útiles para prevenir falsos positivos en programas antivirus y de seguridad. Los falsos positivos ocurren cuando un programa o archivo se marca como malicioso o dañino cuando en realidad es seguro. Al utilizar una lista blanca, los programas de seguridad pueden evitar estos falsos positivos, lo que puede ahorrar tiempo y evitar alertas innecesarias.
El uso de hashes y listas negras/blancas puede ser una forma eficaz de protegerse contra amenazas conocidas y evitar falsos positivos en programas antivirus y de seguridad.
¿Por qué los antivirus utilizan varios algoritmos hash?
Los programas antivirus utilizan múltiples algoritmos hash por varias razones:
- Resistencia al ataque de colisiónSi bien las listas negras pueden ser eficaces para detectar y prevenir amenazas conocidas, no son infalibles. Los atacantes pueden utilizar diversas técnicas para evadir la detección, como modificar los datos para evitar que coincidan las firmas de la lista negra. Estas técnicas se denominan “ataques de colisión”. <br> Un ataque de colisión es un tipo de ataque criptográfico en el que un atacante intenta encontrar dos entradas diferentes, como archivos o mensajes, que produzcan el mismo valor hash cuando se ejecutan a través de una función hash (colisión). El objetivo de un ataque de colisión es crear un par de entradas que puedan usarse para subvertir un sistema que depende de la integridad de los valores hash, como firmas digitales, autenticación de contraseñas o comprobaciones de integridad de datos. Si un atacante puede encontrar una colisión, puede usarla para eludir las medidas de seguridad que dependen de la función hash. <br> Para mitigar el riesgo de ataques de colisión, los antivirus utilizan potentes funciones hash que son resistentes a los ataques y utilizan varias funciones hash simultáneamente. Por ejemplo, si un programa antivirus solo utiliza el algoritmo hash MD5, un atacante podría crear un archivo malicioso que tenga el mismo hash MD5 que un archivo legítimo y engañar al programa antivirus para que trate el archivo malicioso como seguro. Sin embargo, el uso de múltiples algoritmos hash, como MD5, SHA-1 y SHA-256, hace que sea más difícil para un atacante crear un ataque de colisión que funcione contra todos los algoritmos simultáneamente.
- EficienciaLos diferentes algoritmos hash tienen diferentes requisitos computacionales y algunos pueden ser más eficientes que otros dependiendo del tamaño del archivo, el tipo u otros factores. El uso de múltiples algoritmos hash permite a los programas antivirus seleccionar el algoritmo más apropiado para una situación determinada, lo que puede ahorrar tiempo y potencia de procesamiento. Por ejemplo, SHA-256 puede ser más intensivo desde el punto de vista computacional que MD5, por lo que un programa antivirus puede optar por utilizar MD5 para archivos más pequeños y SHA-256 para archivos más grandes.
- FlexibilidadSe diseñan diferentes algoritmos hash para diferentes casos de uso y aplicaciones. Al utilizar múltiples algoritmos hash, los programas antivirus pueden adaptarse a diferentes necesidades y escenarios, como detectar malware, verificar la integridad de los archivos o detectar manipulaciones o modificaciones. Por ejemplo, un investigador forense puede utilizar un algoritmo hash diferente al de un programa antivirus para garantizar que los datos no se hayan modificado durante una investigación.
El uso de múltiples algoritmos hash es una de las mejores prácticas en el desarrollo de software antivirus y de ciberseguridad, ya que proporciona solidez, compatibilidad, eficiencia y flexibilidad para detectar y prevenir amenazas cibernéticas.
¿Cómo reconocen los antivirus datos y archivos similares pero no idénticos?
Archivos similares pero no idénticos pueden ser un problema en ciberseguridad porque los atacantes pueden utilizarlos para evadir la detección del software antivirus.
Por ejemplo, un atacante puede tomar un archivo de malware conocido y realizar ligeras modificaciones en su código o estructura, como cambiar nombres de variables o reordenar instrucciones. Estas modificaciones pueden ser suficientes para crear un nuevo archivo que sea similar pero no idéntico al archivo de malware original, y que puede no ser detectado por el software antivirus que se basa en métodos tradicionales de detección basados en hash.
Además, los atacantes pueden utilizar archivos similares pero no idénticos para crear malware polimórfico, que puede cambiar su código o estructura con cada infección para evitar ser detectado. El malware polimórfico puede ser muy difícil de detectar utilizando técnicas antivirus tradicionales, que se basan en el reconocimiento de patrones o firmas específicas en el código del malware.
Para solucionar este problema, los antivirus utilizan hash difusos.
El hashing difuso es una técnica utilizada por algunos programas antivirus para detectar archivos similares pero no idénticos, incluido el malware polimórfico. Al dividir un archivo en partes más pequeñas y comparar los hashes de esas partes con los de otros archivos, el hash difuso puede identificar archivos que tienen un código o una estructura similar, incluso si no son idénticos.
El hashing difuso funciona identificando secuencias de bytes que aparecen con frecuencia en el archivo. Estas secuencias, también conocidas como "fragmentos", luego se procesan mediante una función hash criptográfica para generar un valor hash. Luego, los valores hash de los fragmentos se comparan con los de otros archivos para identificar fragmentos que son similares.
La ventaja del hashing difuso es que puede detectar similitudes incluso cuando los archivos han sido modificados u ofuscados, lo que lo convierte en una poderosa herramienta para identificar variantes de malware conocido. Por ejemplo, si un atacante modifica un archivo de malware conocido cambiando los nombres de variables o funciones, es posible que los métodos tradicionales de detección basados en hash no detecten el archivo modificado. Sin embargo, el hashing difuso aún puede detectar el archivo modificado identificando fragmentos similares a los del archivo de malware original.
A diferencia de los algoritmos hash criptográficos como MD5, SHA-1 o SHA-512, los algoritmos hash difusos producen valores hash de longitud variable que se basan en la similitud de los datos de entrada.
Ventajas de los hashes difusos
- Detección de archivos similares: Los hashes difusos pueden detectar archivos similares incluso si se han modificado ligeramente, lo que resulta útil para identificar variantes de malware conocido.
- Reducción de falsos positivos: Los hashes difusos pueden reducir la cantidad de falsos positivos generados por los métodos de detección tradicionales basados en hash. Esto se debe a que los hashes difusos pueden detectar archivos que son similares pero no idénticos a malware conocido.
- Resiliencia a la ofuscación: Los hashes difusos son más resistentes a las técnicas de ofuscación utilizadas por los atacantes para evadir la detección. Esto se debe a que el algoritmo de hash difuso divide el archivo en partes más pequeñas y genera hash para cada parte, lo que hace más difícil para un atacante modificar el archivo de una manera que eluda la detección.
Limitaciones del hashing difuso
- Falsos positivos: El hashing difuso puede producir falsos positivos, donde los archivos legítimos se marcan como maliciosos porque tienen un código o una estructura similar al malware conocido. Esto puede ocurrir si los archivos comparten bibliotecas o marcos comunes.
- Actuación: El hashing difuso puede requerir una gran cantidad de cálculo, especialmente para archivos grandes. Esto puede ralentizar el proceso de escaneo y afectar el rendimiento del sistema.
- Limitaciones de tamaño: Es posible que el hash difuso no funcione bien en archivos muy pequeños o con baja entropía, ya que es posible que no haya suficientes fragmentos únicos para generar hashes significativos.
- manipulación: El hashing difuso puede no ser efectivo si un atacante lo ataca específicamente y modifica un archivo para evitar su detección. Por ejemplo, un atacante podría cambiar deliberadamente la estructura de un archivo para evitar que sea identificado mediante hash difuso.
¿Cuál es la diferencia entre algoritmos hash criptográficos y algoritmos hash difusos?
Los algoritmos hash criptográficos y los algoritmos hash difusos se utilizan en ciberseguridad, pero tienen diferentes propósitos y características.
Los algoritmos hash criptográficos, como SHA-256 y MD5, están diseñados para proporcionar integridad y autenticidad de los datos generando valores hash únicos de longitud fija que son casi imposibles de realizar mediante ingeniería inversa. Los algoritmos hash criptográficos se utilizan para verificar la integridad de los datos.
Los algoritmos hash difusos, como SSDEEP, están diseñados para identificar datos similares pero no idénticos, como archivos que han sido modificados o reempaquetados por autores de malware. El hashing difuso utiliza una técnica de ventana deslizante para dividir los datos en pequeños fragmentos y generar hashes probabilísticos de longitud variable que se comparan con una base de datos de hashes de malware conocidos para identificar archivos potencialmente maliciosos.
Los algoritmos hash criptográficos están diseñados para ser resistentes a colisiones, lo que significa que es extremadamente difícil encontrar dos entradas que produzcan la misma salida hash. Los algoritmos hash difusos no necesitan ser resistentes a colisiones, ya que están diseñados para detectar similitudes entre archivos en lugar de producir resultados hash únicos.
La principal diferencia entre los algoritmos hash criptográficos y los algoritmos hash difusos es su nivel de determinismo. Los algoritmos hash criptográficos producen hashes deterministas de longitud fija que son únicos para cada entrada, mientras que los algoritmos hash difusos producen hashes probabilísticos de longitud variable que son similares para entradas similares.
¿Qué algoritmos de hash difusos usaremos en nuestra solución?
En nuestra solución vamos a utilizar SSDEEP y TLSH.
ssdeep es un algoritmo hash difuso que se utiliza para identificar datos similares pero no idénticos, como variantes de malware. Funciona generando un valor hash que representa la similitud de los datos de entrada, en lugar de un identificador único como las funciones hash criptográficas. La salida de ssdeep es de longitud variable y probabilística, lo que le permite detectar incluso diferencias menores entre dos archivos. ssdeep se usa comúnmente en el análisis y detección de malware y también está integrado en varias herramientas de seguridad y software antivirus.
TLSH (Trend Micro Locality Sensitive Hash) es un algoritmo de hash difuso que se utiliza para identificar datos similares pero no idénticos, como variantes de malware. Funciona creando un valor hash que captura las características únicas de los datos de entrada, como la frecuencia y el orden de los bytes. La salida de TLSH es de longitud variable y probabilística, lo que le permite detectar similitudes incluso si los datos de entrada han sido modificados u ofuscados. TLSH se usa comúnmente en el análisis y detección de malware y también está integrado en varias herramientas de seguridad y software antivirus.
ssdeep y TLSH utilizan métricas de distancia para determinar la similitud entre dos valores hash. Sin embargo, las métricas de distancia utilizadas por ssdeep y TLSH son diferentes.
ssdeep utiliza la métrica de "distancia hash difusa" para calcular la distancia entre dos valores hash. Esta métrica de distancia se basa en la cantidad de bloques coincidentes y no coincidentes entre los dos hashes, así como en el tamaño de los hashes. La métrica de distancia es un valor porcentual que varía de 0 a 100, donde 0 significa que los dos hashes son idénticos y 100 significa que los dos hashes son completamente diferentes.
TLSH, por otro lado, utiliza la métrica de "diferencia total" para calcular la distancia entre dos valores hash. Esta métrica de distancia se basa en la diferencia entre las características sensibles a la localidad de los dos conjuntos de datos de entrada. El resultado de la métrica de "diferencia total" es un valor entre 0 y 1000, donde 0 significa que los dos valores hash son idénticos y 1000 significa que los dos valores hash son completamente diferentes.
Construyendo el módulo hash
Para nuestra solución, utilizaremos bibliotecas de código abierto:
- PolarSSL: https://polarssl.org/PolarSSL es una biblioteca de software gratuita y de código abierto para implementar protocolos criptográficos como Transport Layer Security (TLS), Secure Sockets Layer (SSL) y Datagram Transport Layer Security (DTLS). Proporciona varios algoritmos y protocolos criptográficos, incluidas funciones hash, cifrado simétrico y asimétrico, firmas digitales y algoritmos de intercambio de claves. PolarSSL está diseñado para ser liviano y eficiente, lo que lo hace adecuado para su uso en entornos con recursos limitados.
- ssdeep: http://ssdeep.sf.net/
- TLSH: https://github.com/trendmicro/tlsh/
Después de implementar las bibliotecas en el proyecto, agregamos un código simple:
struct HashData
{
 BYTE md5[16];
 BYTE sha1[20];
 BYTE sha512[64];
 std::string ssdeep;
 std::string tlsh;
};

HashData hash(const void* buff, uint64_t size)
{
 HashData snap = {};

 hashes::md5(buff, size, snap.md5);
 hashes::sha1(buff, size, snap.sha1);
 hashes::sha4(buff, size, snap.sha512);

 snap.ssdeep = hashes::ssdeepHash(buff, size);
 snap.tlsh = hashes::tlshHash(buff, size);

 return snap;
}
Comprobando el módulo hash
¡Es hora de probar el módulo hash! Para ello crearemos un archivo de texto con el siguiente contenido:
All the World`s a Stage by William Shakespeare
All the world`s a stage,
And all the men and women merely players;
They have their exits and their entrances,
And one man in his time plays many parts,
His acts being seven ages. At first, the infant,
Mewling and puking in the nurse`s arms.
Then the whining schoolboy, with his satchel
And shining morning face, creeping like snail
Unwillingly to school. And then the lover,
Sighing like furnace, with a woeful ballad
Made to his mistress` eyebrow. Then a soldier,
Full of strange oaths and bearded like the pard,
Jealous in honor, sudden and quick in quarrel,
Seeking the bubble reputation
Even in the cannon`s mouth. And then the justice,
In fair round belly with good capon lined,
With eyes severe and beard of formal cut,
Full of wise saws and modern instances;
And so he plays his part. The sixth age shifts
Into the lean and slippered pantaloon,
With spectacles on nose and pouch on side;
His youthful hose, well saved, a world too wide
For his shrunk shank, and his big manly voice,
Turning again toward childish treble, pipes
And whistles in his sound. Last scene of all,
That ends this strange eventful history,
Is second childishness and mere oblivion,
Sans teeth, sans eyes, sans taste, sans everything.
PRUEBA 1: cree dos archivos idénticos con el mismo contenido (texto arriba) y calcule hashes.


SSDEEP dice que los archivos son 100% idénticos. TLSH dice que hay 0% de diferencias entre archivos.
TEST 2: Crea dos archivos idénticos con el mismo contenido, realiza cambios en el segundo archivo y calcula hashes
Contenido del segundo archivo:
All the World`s a Stage by William Shakespeare
O lovely maidens, fall in love,
But not with Muscovites,
For Muscovites are foreign folk,
They do not treat you right.
A Muscovite will love for sport,
And laughing go away;
They have their exits and their entrances,
And one man in his time plays many parts,
His acts being seven ages. At first, the infant,
Mewling and puking in the nurse`s arms.
Then the whining schoolboy, with his satchel
And shining morning face, creeping like snail
Unwillingly to school. And then the lover,
Sighing like furnace, with a woeful ballad
Made to his mistress` eyebrow. Then a soldier,
Full of strange oaths and bearded like the pard,
Jealous in honor, sudden and quick in quarrel,
Seeking the bubble reputation
Even in the cannon`s mouth. And then the justice,
In fair round belly with good capon lined,
With eyes severe and beard of formal cut,
Full of wise saws and modern instances;
And so he plays his part. The sixth age shifts
Into the lean and slippered pantaloon,
With spectacles on nose and pouch on side;
His youthful hose, well saved, a world too wide
For his shrunk shank, and his big manly voice,
Turning again toward childish treble, pipes
And whistles in his sound. Last scene of all,
That ends this strange eventful history,
Is second childishness and mere oblivion,
Sans teeth, sans eyes, sans taste, sans everything.

SSDEEP dice que los archivos son 88% idénticos. TLSH dice que hay diferencias del 4,7% entre los archivos.
TEST 3: calcula hashes para dos archivos de texto completamente diferentes
Contenido del segundo archivo:
"Katerina", poem of Taras Shevchenko
(translated by John Weir)

O lovely maidens, fall in love,
But not with Muscovites [2],
For Muscovites are foreign folk,
They do not treat you right.
A Muscovite will love for sport,
And laughing go away;
He`ll go back to his Moscow land
And leave the maid a prey
To grief and shame...
It could be borne
If she were all alone,
But scorn is also heaped upon
Her mother frail and old.
The heart e`en languishing can sing –
For it knows how to wait;
But this the people do not see:
“A strumpet!“ they will say.
O lovely maidens, fall in love,
But not with Muscovites,
For Muscovites are foreign folk,
They leave you in a plight.
Young Katerina did not heed
Her parent`s warning words,
She fell in love with all her heart,
Forgetting all the world.

The orchard was their trysting-place;
She went there in the night
To meet her handsome Muscovite,
And thus she ruined her life.
Her anxious mother called and called
Her daughter home in vain;
There where her lover she caressed,
The whole night she remained.
Thus many nights she kissed her love
With passion strong and true,
The village gossips meanwhile hissed:
“A girl of ill repute!”
Let people talk, let gossips prate,
She does not even hear:
She is in love, that`s all she cares,
Nor feels disaster near.
Bad tidings came of strife with Turks,
The bugles blew one morn:
Her Muscovite went off to war,
And she remained at home.
A kerchief o`er her braids they placed
To show she`s not a maid,
But Katerina does not mind,
Her lover she awaits.
He promised her that he’d return
If he was left alive,
That he`d come back after the war –
And then she`d be his wife,
An army bride, a Muscovite
Herself, her ills forgot,
And if in meantime people prate,
Well, let the people talk!
She does not worry, not a bit –
The reason that she weeps
Is that the girls at sundown sing
Without her on the streets.
No, Katerina does not fret –
And jet her eyelids swell,
And she at midnight goes to fetch

The water from the well
So that she won`t by foes be seen;
When to the well she comes,
She stands beneath the snowball-tree
And sings such mournful songs,
Such songs of misery and grief,
The rose .itself must weep.
Then she comes home - content that she
By neighbours was not seen.
No, Katerina does not fret.
She`s carefree as can be -
With her new kerchief on her head
She looks out on the street.
So at the window day by day
Six months she sat in vain....
With sickness then was overcome,
Her body racked with pain.
Her illness very grievous proved.
She barely breathed for days ...
When it was over - by the stove
She rocked her tiny babe.
The gossips` tongues now got free rein.
The other mothers jibed
That soldiers marching home again
At her house spent the night.
“Oh, you have reared a daughter fair.
And not alone beside
The stove she sits - she`s drilling there
A little Muscovite.
She found herself a brown-eyed son...
You must have taught her how!...
Oh fie on ye, ye prattle tongues,
I hope yourselves you`ll feel
Someday such pains as she who bore
A son that you should jeer!
Oh, Katerina, my poor dear!
How cruel a fate is thine!

SSDEEP dice que los archivos son completamente diferentes, con 0% de coincidencias. Sin embargo, TLSH dice que los archivos son sólo un 27,1% diferentes.
¿Por qué es eso? Después de todo, consideramos la distancia entre dos archivos de texto completamente diferentes, ¿verdad?
El caso es que, como dijimos anteriormente, el algoritmo TLSH tiene en cuenta las frecuencias. A pesar de que los textos son diferentes, están escritos en el mismo idioma, usan el mismo alfabeto y tienen la misma cantidad de palabras. Esta característica de este algoritmo hash ayuda a detectar modificaciones de archivos maliciosos.
TEST 4: compara 2 archivos del sistema Windows

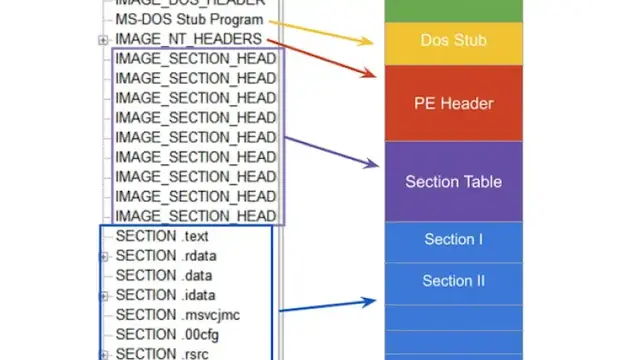
SSDEEP dice que los archivos son completamente diferentes, con 0% de coincidencias. Sin embargo, el algoritmo TLSH dice que los archivos difieren sólo en un 14,5%. Esto se debe en parte al hecho de que lo más probable es que los archivos hayan sido creados por el mismo compilador, por la misma empresa, posiblemente utilizando los mismos patrones de código. Los archivos tienen encabezados VERSION_INFO y MZ similares.
TEST 5: compare 2 archivos del sistema y nuestro archivo hashpair.exe

SSDEEP dice que los archivos son completamente diferentes, con 0% de coincidencias. El algoritmo TLSH dice que los archivos difieren significativamente, en un 73,3%. Estos archivos fueron compilados por diferentes empresas, utilizando diferentes bibliotecas y diferentes compiladores. Estos archivos tienen diferentes VERSION_INFO y diferentes encabezados MZ. Así, el algoritmo TLSH permite categorizar archivos ejecutables, ayudando a identificar archivos maliciosos similares o archivos maliciosos de la misma familia.
Lista de herramientas utilizadas
- WinMerge: https://winmerge.orgWinMerge es una herramienta de fusión y diferenciación de código abierto para Windows. WinMerge puede comparar tanto carpetas como archivos, presentando diferencias en un formato de texto visual fácil de entender y manejar.
- Bloc de notas++: https://notepad-plus-plus.org/downloadsNotepad++ es un editor de código fuente gratuito (como en “libertad de expresión” y también como en “cerveza gratis”) y sustituto del Bloc de notas que admite varios idiomas. Al ejecutarse en el entorno MS Windows, su uso se rige por la Licencia Pública General GNU.
GITHUB
Puedes encontrar el código de todo el proyecto en nuestro github:https://github.com/SToFU-Systems/DSAVE
¿QUÉ SIGUE?
Apreciamos su apoyo y esperamos su participación continua en nuestra comunidad.
En el próximo artículo escribiremos junto con usted el analizador de recursos PE más sencillo.
Cualquier consulta de los autores del artículo puede enviarse al correo electrónico: artículos@stofu.io
¡Gracias por su atención y que tenga un buen día!